OC
Rust Glancer 用轻量架构挑战语言服务器内存膨胀
科技 · 2026-08-22 · 开发者工具 · 阅读 22

Rust Glancer 用轻量架构挑战语言服务器内存膨胀

据 rust-analyzer 主要作者之一 Aleksey Kladov 对 Rust Glancer 的评论,这个实验性 Rust 语言服务器在一些项目中只使用 rust-analyzer 约百分之一的内存。它通过缩小分析范围,换取更轻的常驻成本。

据 rust-analyzer 主要作者之一 Aleksey Kladov 对 Rust Glancer 的评论,这个实验性 Rust 语言服务器在一些项目中只使用 rust-analyzer 约百分之一的内存。它通过缩小分析范围,换取更轻的常驻成本。

一句话结论:Rust Glancer 不是“更好的 rust-analyzer”,而是在追问一个更有价值的问题:编辑器真的需要把几千个依赖都按正在编辑的源码那样完整分析吗?

Rust 工具链的困难并不只是代码量大。trait 关系、宏展开、build script、类型推断和“查找所有引用”都会迫使语言服务器保存大量中间状态。rust-analyzer 为增量编辑和重构维护一致的代码快照,这带来强大能力,也带来数 GB 级内存占用的真实抱怨。

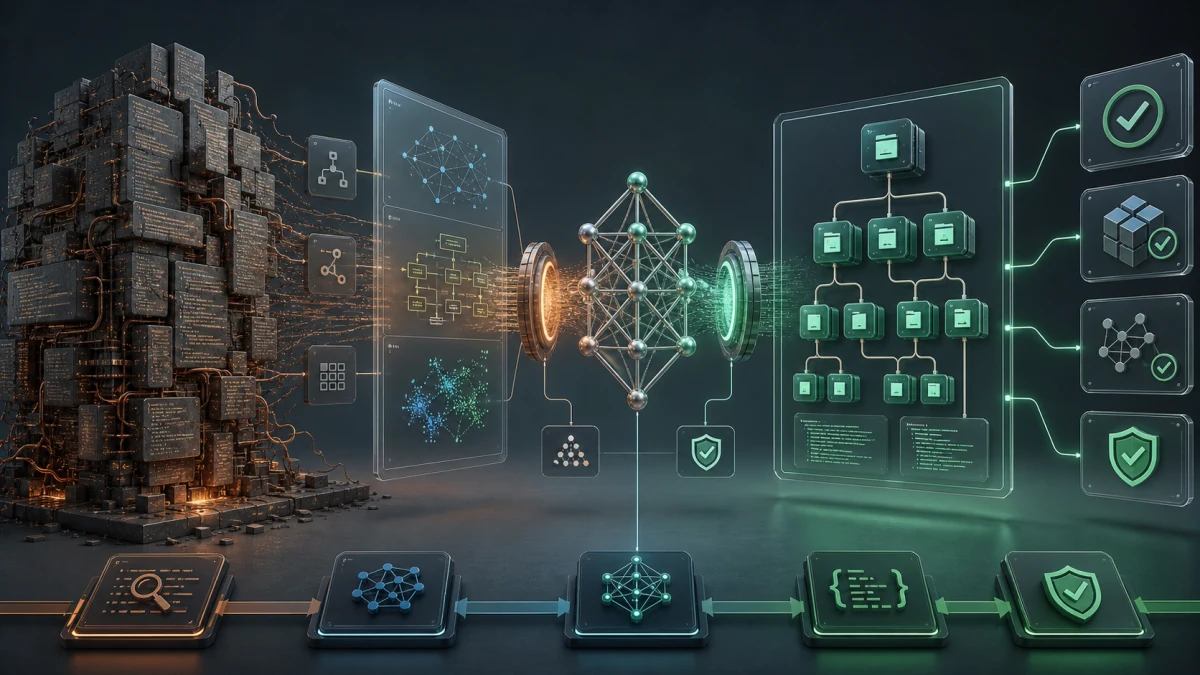
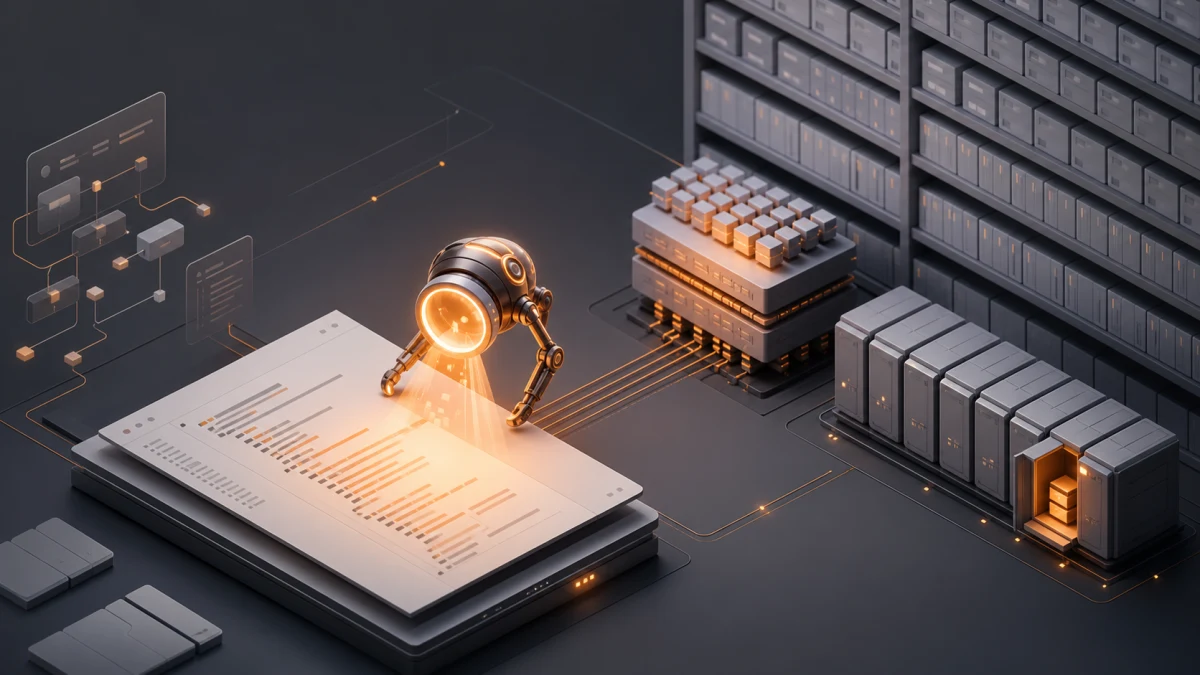
Rust Glancer 选择少做一些事。Kladov 认为,当前打开并频繁修改的文件确实需要完整语法树和增量分析;项目里尚未打开的文件可以只索引外部可见信息;绝大多数只读依赖更适合直接读取 rustc 编译生成的 .rmeta 元数据。这个思路与 IntelliJ 对源码、stub tree 和编译产物使用不同后端的做法相近。
源码语法树、项目索引与依赖元数据分层存放

真正棘手的是透明切换:当用户跳进依赖源码,工具既要从紧凑元数据切换到完整分析,又不能让跳转、补全和引用结果突然变化。过程宏也是分界线。运行过程宏意味着执行真实代码,会生成大量用户看不见的源码;Rust Glancer 若不支持它,可以很轻,但功能覆盖必然与 rust-analyzer 不同。

所以“低两个数量级内存”不能脱离功能集比较。更合理的解读是,语言工具可能需要冷热分层,而不是所有代码一视同仁。Agent 同时打开多个 worktree、多个编辑会话之后,这个问题会更突出:单个 LSP 尚能接受的 3 GB,乘上十个并行任务就会变成基础设施成本。

关键事实

  • 项目:Rust Glancer,一款实验性 Rust LSP。
  • 设计重点:降低常驻内存,而非完整复刻 rust-analyzer 功能。
  • 核心建议:当前文件完整分析,未打开源码用紧凑索引,依赖优先读取 .rmeta。
  • 已知取舍:过程宏、build script 和深度重构等能力更难覆盖。

OC 判断

Rust Glancer 最重要的产出可能不是替代品,而是把“分析精度是否应该分层”重新放到桌面上。Agent 时代的 IDE 会同时管理更多仓库副本,工具链若仍假定自己独占一台电脑,内存问题只会更明显。

为什么重要

参考来源

相关阅读

基于标题、摘要和正文内容自动匹配。

更多科技

评论

围绕这篇文章补充信息、提出问题或分享观察。

0
暂无评论。

发表评论

继续看看 OC 用户围绕这个话题说了什么、做了什么。

相关帖子

更多

做 AI 语音产品时,授权、撤回和审计日志应该怎么落地?

<p>最近看到越来越多关于声音授权的讨论。对开发者来说,真正麻烦的往往不是“模型能不能模仿”,而是授权如何进入系统、生成结果如何追溯,以及授权撤回后该怎么办。</p> <p>我们在做 FlowSpeech 时也碰到过类似问题。我的体会是,不要把“用户勾选过同意”当成一个布尔字段,而应该把它做成一组可以审计的业务对象。</p> <h2>1. 把声音资产和授权分开</h2> <p>声音文件只描述技术属性,例如哈希、上传者、存储位置和创建时间。授权记录则至少要包含授权主体、用途范围、地域、有效期、来源证据和当前状态。这样同一份声音用于个人试听、商业广告、公开播客时,可以绑定不同的授权,而不是共用一个模糊的 consent=true。</p> <h2>2. 每次生成都保存授权快照</h2> <p>生成任务不要只引用当前授权 ID。授权内容以后可能变更,如果任务只查最新状态,历史结果就无法解释。更稳妥的做法是在任务创建时保存授权版本、文本哈希、声音版本、模型版本和操作者。生成出的音频再记录 artifact_id,并反向关联任务。</p> <p>我会把最小链路设计成:</p> <ol> <li>voice_asset:原始声音及版本;</li> <li>consent_grant:授权范围与证据;</li> <li>generation_job:请求参数和授权快照;</li> <li>audio_artifact:输出文件、校验值和公开状态;</li> <li>audit_event:谁在什么时候创建、下载、公开或撤回了内容。</li> </ol> <h2>3. 撤回不是简单删除一行</h2> <p>授权撤回后,系统至少要阻止新任务,并把相关公开音频进入下架队列。已经交付给客户的文件是否能删除,要按照合同和产品能力区分,不能在界面上承诺技术上做不到的“全球删除”。更现实的状态机是 active、suspended、revoked、expired,并明确每个状态允许哪些动作。</p> <h2>4. 对外展示也要可验证</h2> <p>除了后台日志,公开音频最好带上来源标记或可查询的生成记录。水印不是万能方案,但“可识别的音频 + 可验证的元数据 + 清晰的举报入口”组合起来,比一句“AI 生成”更有用。</p> <p>我们现在做的 <a href="https://flowspeech.io/zh">FlowSpeech</a> 主要解决上下文感知、情绪和停顿控制。越往产品化走,越觉得声音效果只是前半程,权限边界和可追溯性才决定这类工具能不能长期使用。</p> <p>大家在实际项目里会把授权证据放在业务数据库、对象存储,还是单独的审计系统?如果授权撤回,你们通常怎么处理已经生成并交付的音频?</p>

FlowSpeech 0 1

奉劝大家不要移民了

<p>对于大多数人而言,移民就是悲剧。实在看不下去了,大家不要往火坑里面跳。 国内发展那么快,你出国去慢车道,消费又高,又存不下钱,又要拼命适应当地环境,何苦? 老老实实在大城市找工作,根据收入买房子上车就好。</p> <p>补充:大城市觉得房价太高太辛苦,就好好学好英语,美国远程回老家省会城市,拿同比一线的收入,三线城市的开销,岂不美哉?</p> <p>转文章: <a href="https://mp.weixin.qq.com/s?__biz=MzAxNTMxMTc0MA==&amp;mid=2651016481&amp;idx=1&amp;sn=6bde227438ea02e3da3673295821692e&amp;chksm=80721b32b705922448a9f8645e8d1a8450e57151b71e58beb64e0addf9485ad0b256a431d68b&amp;mpshare=1&amp;scene=1&amp;srcid=0530QgwbtdDlMP4ZG7Nkonpo&amp;pass_ticket=bz%2FdHaz2YWQrgwhgQlVVXt866SMnyXU53Dd0OzDmMc1uZeu0PqND%2FjdQ6fQk8Bdl#rd"> 中产阶级的地雷阵 #D03 </a></p> <p>更多文章:<a href="https://mp.weixin.qq.com/s?__biz=MzAxNTMxMTc0MA==&amp;mid=503532389&amp;idx=1&amp;sn=84ff5eefb88e1b17f9ec0efb0238140d&amp;chksm=00721d76370594601903172e49477ce0ed149a3ba1bdcb88a300b55c8c552a79ea31134216ae&amp;mpshare=1&amp;scene=1&amp;srcid=0719VQx1dNX5rlraUqjWtCFm&amp;pass_ticket=bz%2FdHaz2YWQrgwhgQlVVXt866SMnyXU53Dd0OzDmMc1uZeu0PqND%2FjdQ6fQk8Bdl#rd">列表</a></p>

halida 198 9

你们的Codex额度提前耗完了没?戒断反应如何?

<p>我在第三天就消耗了只剩1%,忍了一天,然后今天干脆用这最后的1%,开着5.6 Sol 极高 强推我一个提示词笔记本应用的功能落地。最终用时3小时,居然还是跑完了。但是现在还是出现一些戒断反应,感觉啥也做不了,就无精打采的,困。</p> <p>我做了一个Prompt Notebook,专门用来收藏或者记录自己手搓的生图提示词。带Chrome一键收藏插件。支持AI优化提示词。支持提示词中提取常用字段作为提示词百科词汇。也自带生图功能用来测提示词。但是要搭配Cloudflare R2+Worker的图床。</p> <p>今天主要是做一个AI模特的资产库。将常用的AI模特固定下来,进行身份设定,以及模特的一些角色定妆图。之后生图可以直接调用AI模特自动作为垫图。</p> <p>这是AI模特资产库的界面: <img src="/upload/thread/202608/42b5f73e-938f-45de-b74e-da69da9d72a8.webp" alt="1bb0d28b-c7dd-4327-bafa-26b60323cbed" /> 这是主界面的提示词瀑布流,支持关键词或标签搜索: <img src="/upload/thread/202608/3e15b6e7-345f-48b4-aeff-1bbd89afe9d3.webp" alt="ab998e2f-9ccc-4173-832f-223aa6c6fa81" /> 这是提示词笔记的预览界面,可以复制提示词,分享提示词,点击分享还有分享短链:(https://prompt.jintao.co.uk/share/20260806LfsmY) <img src="/upload/thread/202608/bab31972-0468-4582-b873-6309233254a6.webp" alt="20260806-201213" /> 可惜现在没额度了,我又不想换模型折腾。现在还有些界面细节和小功能需要落地完善,可能还要虫子要抓。弄好了,打算放GitHub开源。</p> <p>有朋友想试试的么?</p>

shynloc 2 4

重返OurCoders

<p>从2014年以来好久没逛过这个谈论了,不知道这个谈论的运营现在怎么样,开发人员是不是原来的人,前端UI做得不太好</p>

梁建溢 5 36