IBM 让同一核心同时懂 z 和 Arm,主机现代化不是推倒重来
IBM 公布了一种面向未来 Z 与 LinuxONE 系统的双指令集处理器设计:同一颗核心可以原生执行 IBM z/Architecture 和 Arm 指令,而不是靠软件模拟,也不是在芯片上并排放置两组完全独立的核心。首个设计采用 2nm 工艺,包含 11 个核心,频率目标超过 5.7GHz。
作者:林岚|OC 开发者生态编辑
IBM 公布了一种面向未来 Z 与 LinuxONE 系统的双指令集处理器设计:同一颗核心可以原生执行 IBM z/Architecture 和 Arm 指令,而不是靠软件模拟,也不是在芯片上并排放置两组完全独立的核心。首个设计采用 2nm 工艺,包含 11 个核心,频率目标超过 5.7GHz。
一句话结论:IBM 想解决的不是让主机“变成 Arm 服务器”,而是让传统交易系统与现代 Arm 软件在同一套可靠性、安全和资源管理体系里共存。
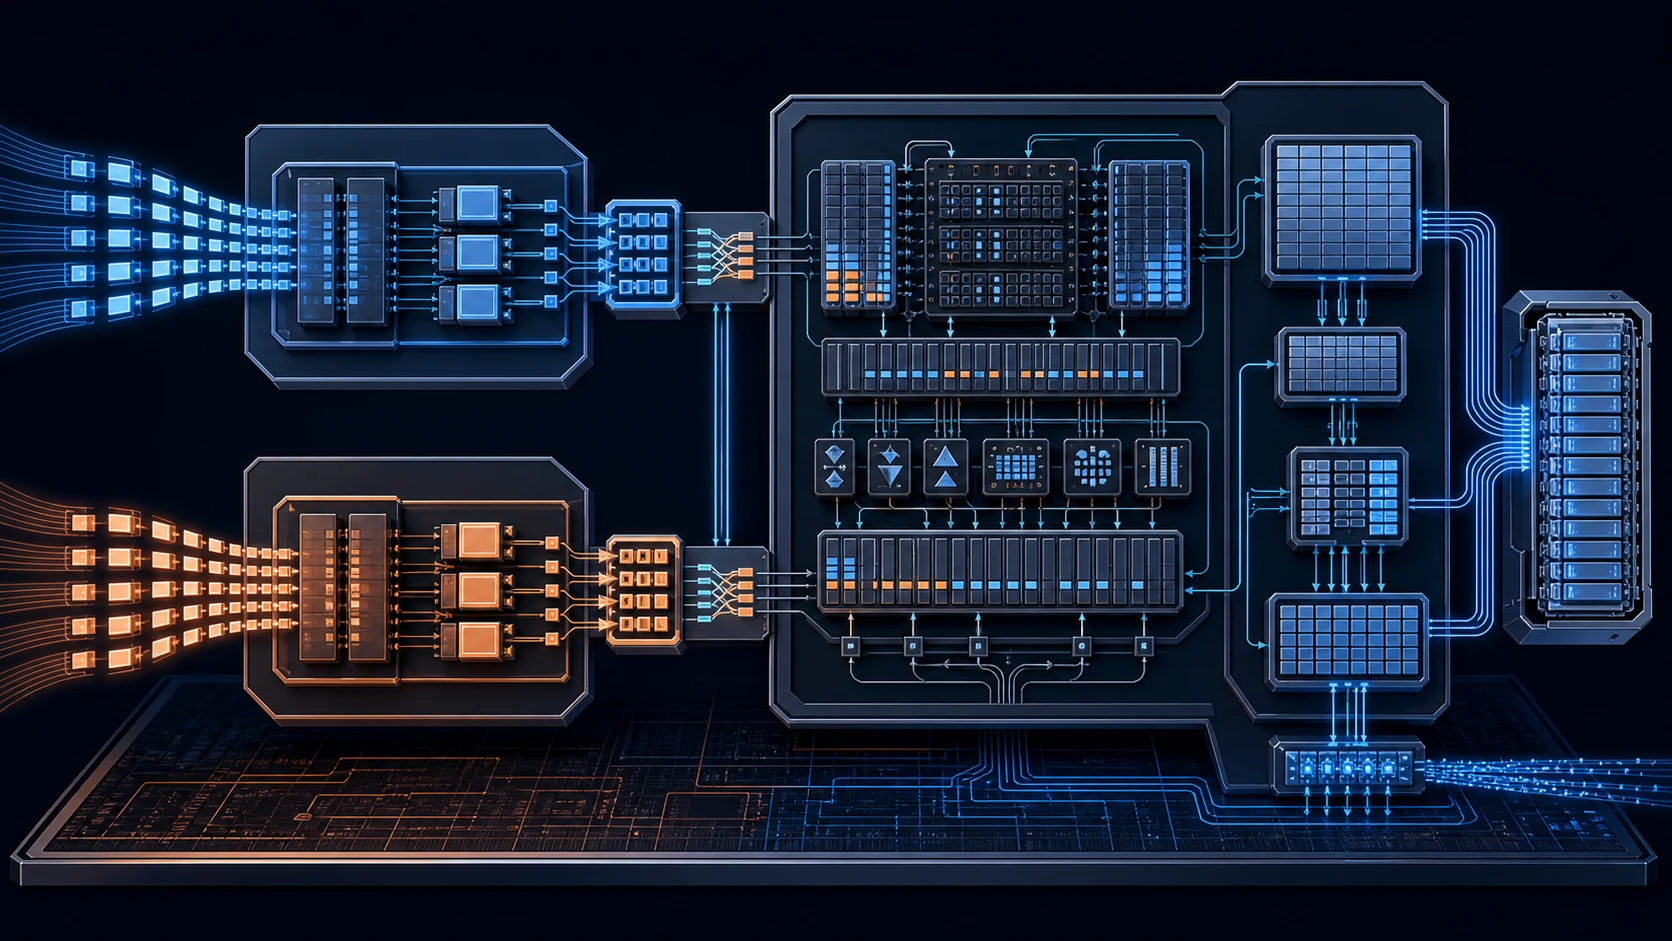
双 ISA 最容易被误解成一次架构替换。实际上,IBM 保留了两套指令解码前端:一种理解 z 指令,一种理解 Arm 指令;它们把操作送入共享的乱序执行后端、缓存、地址转换和其他核心资源。这样既保留各自的软件语义,又避免为两种生态复制整颗处理器。
这种共享并不简单。z/Architecture 与 Arm 对字节序、内存排序、异常和系统行为有不同约定。IBM 称硬件会处理字节序转换,并维持主机工作负载需要的强内存顺序;核心还支持 BF16、FP16 等适合 AI 与现代计算的格式。设计价值不只在“能跑”,而在于减少兼容层对性能与可预测性的影响。
对企业用户,吸引力在软件迁移。银行、保险和政府机构的大量核心交易仍运行在 Z 上,新服务和开源组件却越来越多地面向 Arm 构建。过去它们可能需要独立服务器、虚拟化边界或跨网络调用。若 Arm 工作负载能在同一主机资源池内原生运行,数据移动、延迟和运维边界都有机会缩小。
但“同一核心”也不代表应用可以不经测试直接搬迁。操作系统支持、编译器优化、许可证、性能隔离和故障域仍需要完整验证。两种 ISA 共享后端,还必须证明资源争用不会破坏主机用户看重的确定性与服务等级。
目前这是面向未来产品的技术披露,不是已经可以采购的量产系统。超过 5.7GHz 等参数也应理解为设计目标或公布规格,实际产品的核心数、功耗和部署方式仍可能调整。判断其成功与否,要看 IBM 何时交付、Arm 软件栈支持到什么程度,以及客户是否真能减少旁路服务器。
关键事实
- IBM 公布 2nm、11 核、目标频率超过 5.7GHz 的双 ISA 处理器设计。
- 每个核心通过独立解码前端原生理解 z 与 Arm 指令,并共享执行后端、缓存和地址转换资源。
- 设计面向未来 IBM Z 与 LinuxONE,尚不能写成已经大规模出货的产品。
OC 判断
主机现代化的现实路径通常不是把旧系统推倒重来,而是逐步缩短旧交易与新软件之间的距离。双 ISA 若能兑现隔离、性能和工具链承诺,会让迁移从“换平台”变成“在同一平台重新安排工作负载”。这比一个漂亮的兼容演示更有长期价值。
为什么重要
- 对企业:可在保留关键系统的同时引入更多 Arm 软件与开发工具。
- 对工程团队:兼容性从软件模拟下沉到硬件,但测试和容量规划仍不可省略。
- 对处理器行业:ISA 之争之外,异构软件如何共享同一核心成为新的设计方向。
评论
围绕这篇文章补充信息、提出问题或分享观察。