OC
别再问哪个模型推理最快,先问你站在效率前沿的哪个点
科技 · 2026-09-03 · AI 基础设施 · 阅读 10

别再问哪个模型推理最快,先问你站在效率前沿的哪个点

Baseten 用“效率前沿”解释大模型推理优化:一次部署很难同时把首 token 延迟、输出速度、并发吞吐、单 token 成本和模型质量都做到最好。多数优化是在几项指标间换位置,少数底层改进才会把整条边界向外推。

作者:林岚|OC 开发者生态编辑

Baseten 用“效率前沿”解释大模型推理优化:一次部署很难同时把首 token 延迟、输出速度、并发吞吐、单 token 成本和模型质量都做到最好。多数优化是在几项指标间换位置,少数底层改进才会把整条边界向外推。

一句话结论:“最快模型”几乎总是一个缺少条件的问题;只有把工作负载、服务等级目标和质量下限写清,性能数字才有可比性。

最典型的是批量大小。小批次能让单个请求更早进入 GPU,交互延迟较低,却因为硬件利用率不足而提高单位成本;大批次把更多请求合在一起,吞吐和成本更好,但排队与处理时间增加。聊天产品、代码补全和离线文档处理即使使用同一模型,也不会选择同一个点。

并行策略同样不是免费午餐。张量并行把一次推理拆到多颗 GPU,通常降低单请求延迟,却增加通信和资源占用;专家并行更适合稀疏 MoE 模型的吞吐;数据并行扩展并发,但不能自动改善单个请求。宣传页若只给“每秒 token”,没有说明并发数、批量和硬件数量,就无法判断经济性。
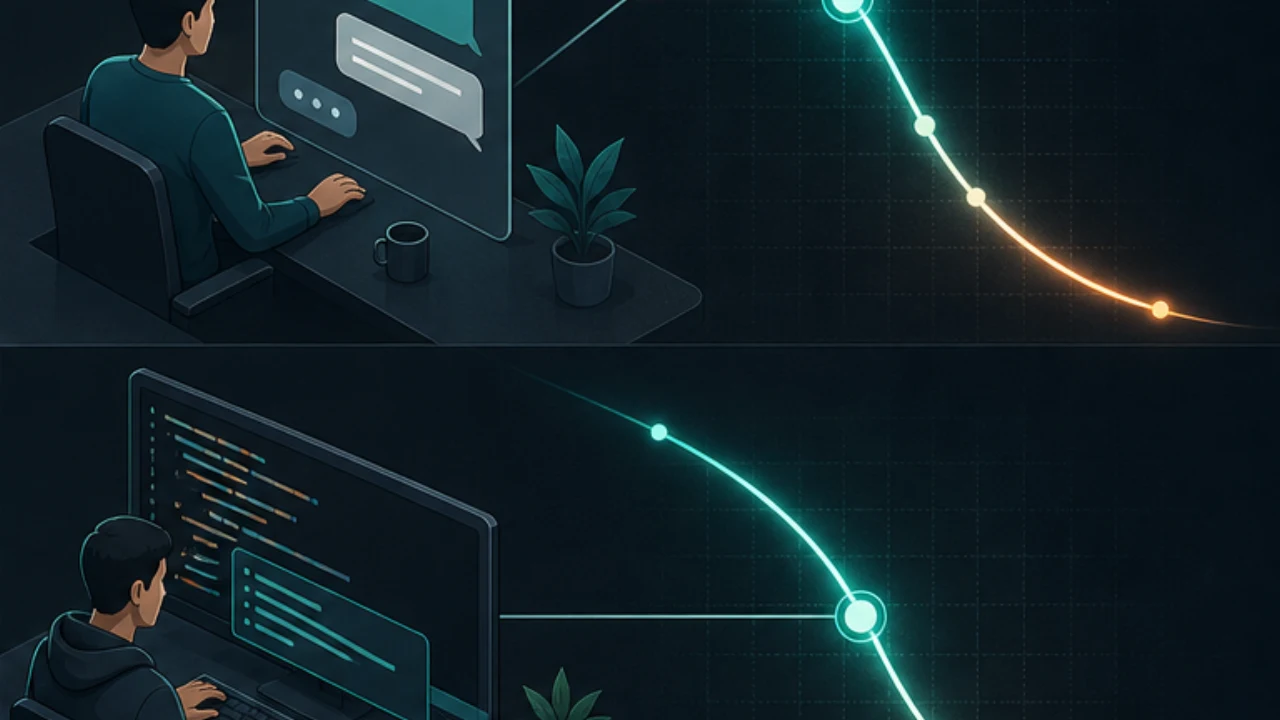
不同业务在同一推理系统上选择不同服务等级点

量化、蒸馏和剪枝又增加了质量轴。更低精度权重能减少显存和计算,让服务边界外移,也可能损伤长尾任务准确率。它不是单纯的“同一模型更省”,而是在质量与效率之间再画一条曲线。上线前需要用自己的数据评估,而不是只看通用榜单。

真正可能同时改善多项指标的,是运行时与系统级进步。更好的 kernel、内存调度、推测解码和 prefill/decode 分离,可以在不改业务目标的情况下提升硬件利用率。尤其对代码生成,预测容易时,推测解码有机会同时降低延迟与计算浪费。但收益仍取决于草稿模型命中率、上下文长度与输出分布。

关键事实

  • 批量、并行与硬件分配通常是在延迟和成本之间移动,不会消灭取舍。
  • 量化会同时改变效率与质量,需要业务数据验证。
  • kernel、推测解码和 prefill/decode 分离等系统改进,才更可能推动整条前沿。

OC 判断

推理评测应该从单点冠军变成一条可复现曲线:固定模型质量下报告多组延迟和吞吐,固定延迟目标下报告成本,并公开硬件、批量、上下文和并发。没有这些条件,所谓“快 3 倍”更像选择了不同赛道,而不是系统真的进步了 3 倍。

为什么重要

  • 对工程团队:部署方案应从业务 SLO 倒推,而不是从排行榜正推。
  • 对采购方:比较成本时要同时计算 GPU 数量、并发和质量回退。
  • 对用户:低延迟与高峰稳定性往往来自不同配置,产品要明确优先级。

参考来源

相关阅读

基于标题、摘要和正文内容自动匹配。

更多科技

评论

围绕这篇文章补充信息、提出问题或分享观察。

0
暂无评论。

发表评论

继续看看 OC 用户围绕这个话题说了什么、做了什么。

相关碎碎念

更多

最近越来越多思考,我们跟agent的关系,比如我最近用blender mcp很多,基本上我算是会用blender的,但是老记不住很多热键,以前我可以做很复杂的模型,但是要是不是的去查blender的操作热键。现在我完全不参与模型的建模,只让codex帮我生成。 但是我还是在查blender的热键,我现在需要的是numpad .这样聚焦到一个对象的方法,我需要的是numpad /这样的方法来把除了选中的对象,其他都隐藏的热键。 换言之,我现在需要高效的人工视觉复检blender mcp的成果,这是我对自己目前blender能力的需求了。

tinyfool 2 0

正在做OC产品频道,支持独立开发者提交自己的app,网站,在OC得到宣传和外链。基础功能已经实现,还有一堆在路上。我们独特的是有一个能力让你把产品的用户写的文章视频也可以列在你的产品页下方。方便更多用户了解,这不是想替代你自己的产品页面,而是帮你把做每个产品页各种复杂的互动都自动化,这个产品页还是可以导流到你自己的产品页的

tinyfool 1 2

从第一份程序员职业至今,已经过了 20 年,现在已经不再亲自写代码了,年初看到 Codex/Claude 火爆,又起心动念开始堆代码,只不过现如果自己亲手写的代码,跟 AI 写的代码放在一起,我开始有种耻感涌上来。是到了把关注点挪到像我这种老登程序员的生活上的时候了。

lgn21st 1 1

相关帖子

更多

你们的Codex额度提前耗完了没?戒断反应如何?

<p>我在第三天就消耗了只剩1%,忍了一天,然后今天干脆用这最后的1%,开着5.6 Sol 极高 强推我一个提示词笔记本应用的功能落地。最终用时3小时,居然还是跑完了。但是现在还是出现一些戒断反应,感觉啥也做不了,就无精打采的,困。</p> <p>我做了一个Prompt Notebook,专门用来收藏或者记录自己手搓的生图提示词。带Chrome一键收藏插件。支持AI优化提示词。支持提示词中提取常用字段作为提示词百科词汇。也自带生图功能用来测提示词。但是要搭配Cloudflare R2+Worker的图床。</p> <p>今天主要是做一个AI模特的资产库。将常用的AI模特固定下来,进行身份设定,以及模特的一些角色定妆图。之后生图可以直接调用AI模特自动作为垫图。</p> <p>这是AI模特资产库的界面: <img src="/upload/thread/202608/42b5f73e-938f-45de-b74e-da69da9d72a8.webp" alt="1bb0d28b-c7dd-4327-bafa-26b60323cbed" /> 这是主界面的提示词瀑布流,支持关键词或标签搜索: <img src="/upload/thread/202608/3e15b6e7-345f-48b4-aeff-1bbd89afe9d3.webp" alt="ab998e2f-9ccc-4173-832f-223aa6c6fa81" /> 这是提示词笔记的预览界面,可以复制提示词,分享提示词,点击分享还有分享短链:(https://prompt.jintao.co.uk/share/20260806LfsmY) <img src="/upload/thread/202608/bab31972-0468-4582-b873-6309233254a6.webp" alt="20260806-201213" /> 可惜现在没额度了,我又不想换模型折腾。现在还有些界面细节和小功能需要落地完善,可能还要虫子要抓。弄好了,打算放GitHub开源。</p> <p>有朋友想试试的么?</p>

shynloc 2 4

做 AI 语音产品时,授权、撤回和审计日志应该怎么落地?

<p>最近看到越来越多关于声音授权的讨论。对开发者来说,真正麻烦的往往不是“模型能不能模仿”,而是授权如何进入系统、生成结果如何追溯,以及授权撤回后该怎么办。</p> <p>我们在做 FlowSpeech 时也碰到过类似问题。我的体会是,不要把“用户勾选过同意”当成一个布尔字段,而应该把它做成一组可以审计的业务对象。</p> <h2>1. 把声音资产和授权分开</h2> <p>声音文件只描述技术属性,例如哈希、上传者、存储位置和创建时间。授权记录则至少要包含授权主体、用途范围、地域、有效期、来源证据和当前状态。这样同一份声音用于个人试听、商业广告、公开播客时,可以绑定不同的授权,而不是共用一个模糊的 consent=true。</p> <h2>2. 每次生成都保存授权快照</h2> <p>生成任务不要只引用当前授权 ID。授权内容以后可能变更,如果任务只查最新状态,历史结果就无法解释。更稳妥的做法是在任务创建时保存授权版本、文本哈希、声音版本、模型版本和操作者。生成出的音频再记录 artifact_id,并反向关联任务。</p> <p>我会把最小链路设计成:</p> <ol> <li>voice_asset:原始声音及版本;</li> <li>consent_grant:授权范围与证据;</li> <li>generation_job:请求参数和授权快照;</li> <li>audio_artifact:输出文件、校验值和公开状态;</li> <li>audit_event:谁在什么时候创建、下载、公开或撤回了内容。</li> </ol> <h2>3. 撤回不是简单删除一行</h2> <p>授权撤回后,系统至少要阻止新任务,并把相关公开音频进入下架队列。已经交付给客户的文件是否能删除,要按照合同和产品能力区分,不能在界面上承诺技术上做不到的“全球删除”。更现实的状态机是 active、suspended、revoked、expired,并明确每个状态允许哪些动作。</p> <h2>4. 对外展示也要可验证</h2> <p>除了后台日志,公开音频最好带上来源标记或可查询的生成记录。水印不是万能方案,但“可识别的音频 + 可验证的元数据 + 清晰的举报入口”组合起来,比一句“AI 生成”更有用。</p> <p>我们现在做的 <a href="https://flowspeech.io/zh">FlowSpeech</a> 主要解决上下文感知、情绪和停顿控制。越往产品化走,越觉得声音效果只是前半程,权限边界和可追溯性才决定这类工具能不能长期使用。</p> <p>大家在实际项目里会把授权证据放在业务数据库、对象存储,还是单独的审计系统?如果授权撤回,你们通常怎么处理已经生成并交付的音频?</p>

FlowSpeech 0 1

一个体会,Codex 这种现代 Agent,每天一个变,几天不用就有新惊喜

<p>当然我说的也包括 Claude Code,新功能日新月异,还有就是 AI 能力提升以后,可以做的东西日新月异。还有各种工作流方法日新月异。</p> <p>更好玩的是,我最近经历过很多次,你跟人介绍现在 Codex 可以做到什么样子,他们都觉得很厉害。但是你现场一演示,他们的震撼就更加完全不同了。所以,这种东西,需要大量的 Workshop 去沟通交流,光看文字很难讲清楚,直播、视频也越来越重要了。</p>

tinyfool 1 89