Wayback Machine 限流误伤真人,公共网页档案也有访问成本
Internet Archive 在 9 月 15 日的官方通告中承认,Wayback Machine 应对高流量自动化访问的保护措施误伤了一些真人用户。团队表示正在减少误判,并为由此造成的不便道歉。这是一则访问故障说明,而不是宣布网页档案停止开放。
作者:周白|OC 产品体验编辑
Internet Archive 在 9 月 15 日的官方通告中承认,Wayback Machine 应对高流量自动化访问的保护措施误伤了一些真人用户。团队表示正在减少误判,并为由此造成的不便道歉。这是一则访问故障说明,而不是宣布网页档案停止开放。
一句话结论:公共档案需要抵御过量请求,也需要让被拦住的普通读者知道发生了什么;限流不能只剩下一个错误码。
被挡在入口,不等于历史记录消失
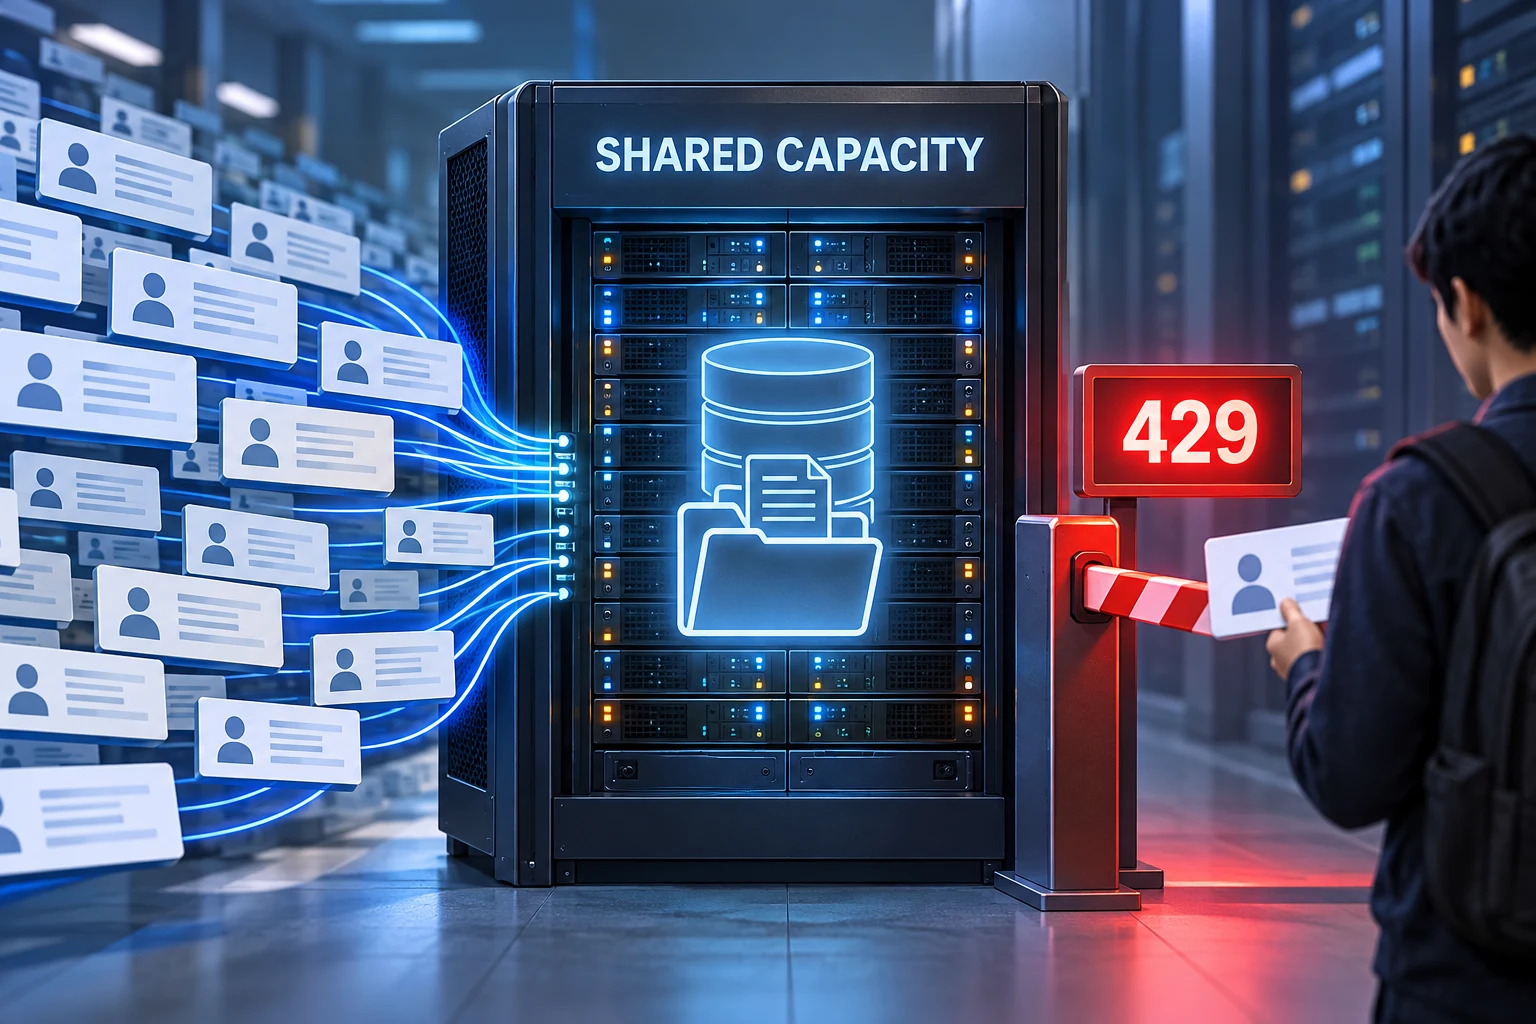
官方披露的事实相当有限:服务经历多波高容量自动化流量,为维持运行采取了保护措施,其中一部分影响到正常访问。团队还重写了 429 错误信息,使“请求过多”的含义更明确。
这段说明没有公布流量规模、具体来源或成本数字,也没有把流量归因于某一家 AI 公司。自动化访问可以有许多用途;仅凭这份通告,无法判断是谁在访问,更不能把“自动化流量”直接改写成已确认的攻击者名单。
对普通读者,最重要的区分是:当前请求被限制,不等于所查网页没有被保存,也不等于已有存档遭到删除。前者是访问服务此刻怎样处理请求的问题,后者是档案内容是否存在的问题。一次错误页面不足以证明后两种结论。
免费入口背后仍是一项在线服务
网页档案的公共价值很容易让人忽略它的运行方式。保存下来与随时向每个请求返回结果,是不同的工作。后者需要持续可用的计算、网络和服务管理;一个人查阅几页,与程序持续批量读取,给入口造成的压力并不相同。
限流因此不天然违背开放。但如果普通读者被误判,又无法分辨究竟是临时限制、浏览器异常还是记录缺失,保护措施就会把服务成本转移成读者的困惑。记者可能怀疑引用失效,研究者可能中断核验,而原本只是想看一张旧页面的人可能直接离开。
这也是改写错误信息的意义。解释不能替代恢复访问,却能避免用户在错误方向上排查。更好的提示应说明当前状态、可采取的合理下一步,以及问题持续时如何反馈;不必泄露防护机制,也可以让真人用户少走弯路。
反馈渠道要有效,也要顾及个人信息
通告请持续遇到问题的用户联系 info@archive.org,并提供操作系统、浏览器和 IP 地址等排查信息。这里的用途是帮助团队定位误判,不是要求用户在社交平台公开自己的网络信息。
如果按通告反馈,应通过其指定渠道提交必要材料,不宜把完整网络信息连同其他私人内容贴到公共讨论区。与此同时,读者也不必靠不断刷新或同时发起更多请求来验证服务是否恢复;那样既不能说明档案是否存在,也可能增加入口压力。
对于依赖网页档案的工作流程,这次事件还提示一个小但实际的习惯:在引用时保留准确的原网址、存档链接和访问时间。它不能保证服务永远在线,却能让一次暂时的访问失败不至于切断全部核验线索。
关键事实
- Internet Archive 确认自动化高流量触发的保护措施存在真人误判。
- 官方已调整 429 提示,并表示正在减少错误拦截。
- 通告没有确认流量来自 AI 抓取,也没有宣布收费、关闭或删除存档。
OC 判断
这不是一条能够据此推导互联网档案商业模式转向的新闻。它暴露的是更具体的运营难题:保护公共资源与保持普通访问可用,必须同时成立。防护是否有效,不能只看挡住了多少请求,还要看被挡错的人能否获得解释和恢复路径。
为什么重要
网页档案承担着引用核验和网络记忆的基础工作。读者无法访问时,损失的不只是一次页面浏览,还有对证据能否被再次找到的信心。把访问状态解释清楚,本身就是公共服务可靠性的一部分。


评论
围绕这篇文章补充信息、提出问题或分享观察。