4B 模型让查询计划快了 81%,答案藏在十五次候选里
开发者 Rohan Bansal 在查询优化实验中报告,一个经微调和强化学习的 4B 模型,在 113 条多表连接查询上获得 1.81 倍的几何平均加速比,总耗时下降 44.7%。但这个结果来自多轮生成、实际测量后挑选候选计划,不是模型随口给出的第一条计划。
作者:林岚|OC 开发者生态编辑
开发者 Rohan Bansal 在查询优化实验中报告,一个经微调和强化学习的 4B 模型,在 113 条多表连接查询上获得 1.81 倍的几何平均加速比,总耗时下降 44.7%。但这个结果来自多轮生成、实际测量后挑选候选计划,不是模型随口给出的第一条计划。
一句话结论:小模型在特定数据库上有调优潜力,真正需要一起计算的,是搜索成本、测量噪声和未来查询能重复多少次。
模型改变的是怎么查,不是查什么
同一条 SQL 可以采用不同的连接顺序、扫描方式和连接算法。最终逻辑结果可以相同,中间处理的数据量却差很多。先把高度选择性的条件用上,可能比先形成巨大中间结果更省工作。
PostgreSQL 的优化器需要快速估算,而不是把所有计划都执行一遍再选择。面对数据相关性等问题,估计可能偏离现实。实验借助 pghintplan 给出执行提示,让模型搜索默认计划之外的方案,并用实际运行反馈判断好坏。
这个定位很重要:它不是宣称用语言模型替换数据库,也不意味着每次查询都适合先等待一个 Agent 做长时间搜索。更合理的目标是反复运行、单次成本较高的分析负载,把前期调优投入摊到后续多次执行里。
十五个候选,是标题必须带着的条件
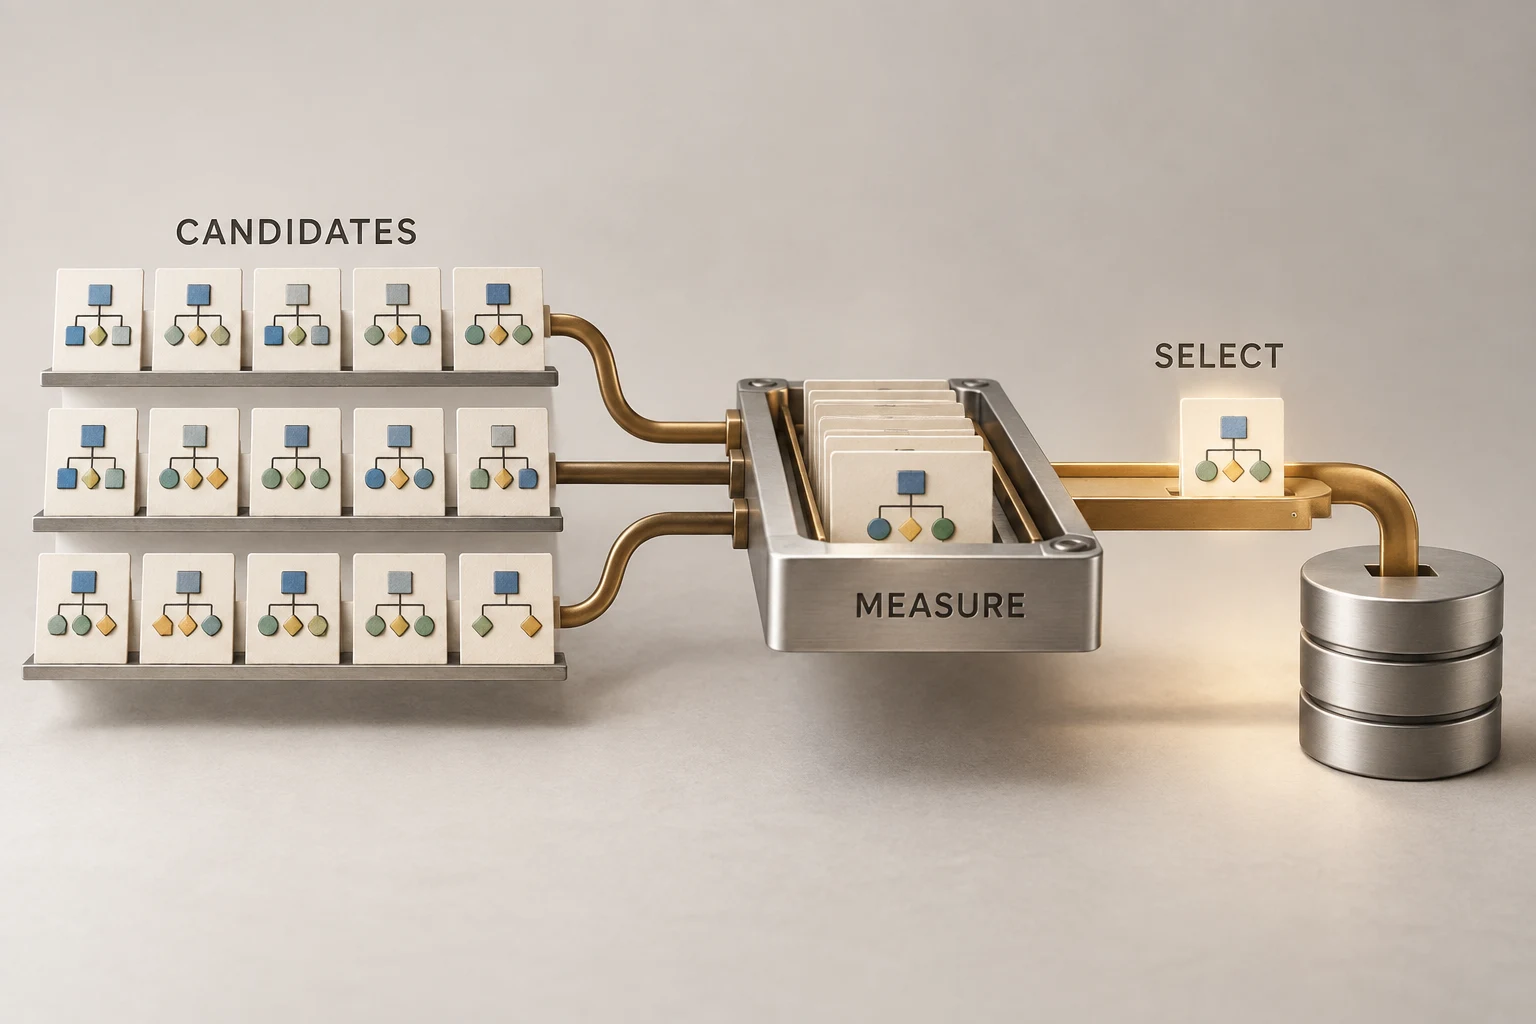
作者最终为每条查询运行三条轨迹,每条最多尝试五个候选,再依据反馈从最多十五个候选中选出方案。1.81 倍属于这一选择设置;仅看每条轨迹中模型自己的最终选择,结果并不相同。
此外,“快 81%”与“时间少 81%”不是一回事。对于单次比较,1.81 倍加速对应新耗时约为旧耗时的 55.2%。但本文的 1.81 倍是多条查询加速比的几何平均,不能直接取倒数来计算整批总耗时;44.7% 是作者另行统计的总耗时降幅。两个数字接近不代表口径相同,更不能把标题里的速度百分比直接拿来扣减账单。
训练先要避免奖励测量运气
这项实验有价值的另一部分,是作者专门处理了数据库缓存和并发测量带来的噪声。同一计划在不同缓存状态下可能有不同耗时。如果系统把偶然快了一次当作策略更好,强化学习就可能追逐错误信号。
作者采用候选与默认方案配对测量等方式,并调整奖励设计。更普遍的工程启示是:可验证任务也不等于反馈天然可靠。计时器能给出数字,但实验环境决定数字能否支持因果判断。
对企业自己的数据库,类似问题还可能来自后台作业、数据增长和资源争用。离线测得更快的方案,仍需要在接近实际负载的条件下确认;数据库内容变化之后,过去的好计划也不一定一直合适。
这不是跨所有数据库的通用胜利
实验用同一 IMDb 数据库上的不同查询集做训练与验证,作者检查了训练、验证查询的连接图拓扑重叠。这有助于避免直接重复题型,却不等于证明换到任意业务数据都能保持收益。
同库学习恰恰可以是一项合理产品取舍:如果团队只想优化自己的固定分析负载,不必先解决所有数据库。但使用者必须知道模型学到的是哪个环境,什么时候需要重新测量,以及没有更好候选时能否保留默认方案。
成本比较也应包括生成、测量和训练,而不只是最后一次 SQL 的执行时间。假设某条报表只运行一次,昂贵搜索很难回本;如果长期重复,前期投入才可能变得划算。本文没有独立复现实验。
关键事实
- 作者报告的 1.81 倍与 44.7% 总耗时下降,来自特定测试和多候选选择。
- 训练与验证围绕同一 IMDb 数据库,并非跨数据库泛化测试。
- 方案依赖实际执行反馈,不是仅凭模型生成计划就确认性能。
OC 判断
值得重视的不是“小模型击败数据库”的戏剧性,而是把大模型示范、小模型学习与可靠测量放到一个窄任务中。它提示了一种可行方向,但不能跳过调优成本和负载适配。
为什么重要
很多企业并不缺通用模型,缺的是能稳定评价结果的任务环境。查询优化展示了这种环境的价值,也说明评价器本身需要工程投入;否则模型可能学到的只是如何赢一场有噪声的比赛。
评论
围绕这篇文章补充信息、提出问题或分享观察。