OC
三值模型压到 1.485 比特,没有打破信息论
科技 · 2026-09-18 · 模型工程 · 阅读 1

三值模型压到 1.485 比特,没有打破信息论

据 arXiv 上的 BITCOS 预印本,英特尔研究人员尝试用另一种布局存储三值大模型权重,最低做到每个权重符号 1.485 比特。论文标题里的“打破 1.58 比特屏障”容易引起误解:变化来自权重分布和编码方式,不是信息论失效。

作者:林岚|OC 开发者生态编辑

arXiv 上的 BITCOS 预印本,英特尔研究人员尝试用另一种布局存储三值大模型权重,最低做到每个权重符号 1.485 比特。论文标题里的“打破 1.58 比特屏障”容易引起误解:变化来自权重分布和编码方式,不是信息论失效。

一句话结论:零权重足够多时,省下重复表示零的空间,可以让三值模型更紧凑;省空间能否转化为推理提速,还要看解包成本与硬件。

先区分三个值和三个等概率的值

三值权重只能取负一、零、正一。若三个符号等概率出现,常见的信息量参照是 log₂3,约为 1.585 比特。但“只能取三个值”并不意味着这三个值出现得一样多。零特别常见时,编码完全可以利用这种不均匀。

BITCOS 的做法可以直观地拆成两份记录:先用位图标出每个位置是否为零,再只给非零位置存正负号。假设零的比例是 z,符号部分的平均空间就是 1+(1-z),即 2-z。零越多,需要额外保存的符号越少。这是改变表示法,没有把原来的非零值偷偷丢掉。

这里的 1.485 也不是整个模型文件、运行内存乃至显存占用统一除以参数量后的结果。缩放因子等附加信息、运行时缓冲区和注意力缓存,需要另算。把权重符号压得更紧凑,与让一台机器能运行多大的完整模型,是相连但不同的两个问题。
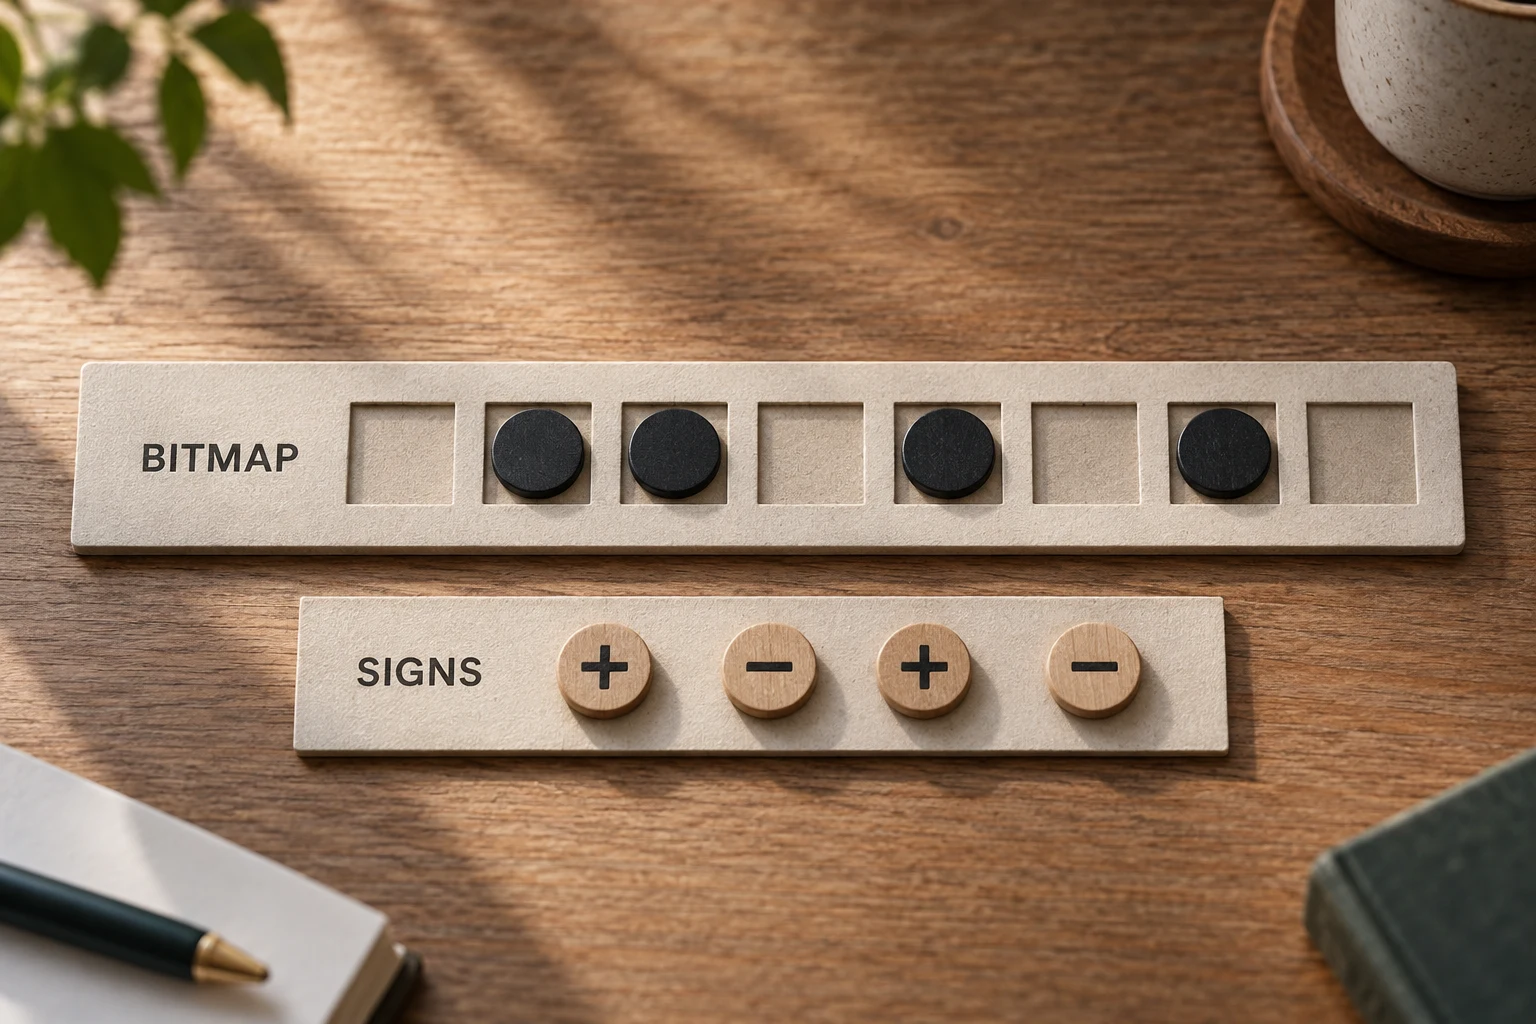
位图标记零与非零,另一条序列仅保存非零项符号;编辑概念图

小文件不能自动兑换快推理

压缩格式最大的工程难点,往往不是写入,而是读取。推理内核需要及时取出当前计算所需的值;如果为节省几个比特增加了复杂分支、索引查找或不规则访问,节省的带宽可能被解包开销吃掉。

因此,一个新布局真正有价值,需要同时回答两个问题:模型中是否有足够多的零,以及目标处理器能否便宜地把布局还原成计算所需的形态。只有第一项好看,得到的可能只是更小的下载包;第二项配合,才有机会改善运行吞吐。

作者在 29 个模型中观察到,26 个采用新布局后的符号存储更紧凑,并为若干 CPU 指令集和英特尔 Xe2 GPU 设计了解包实现。其端到端解码实验报告 CPU 最高约 1.18 倍、GPU 最高约 1.27 倍吞吐。这些都是指定平台、模型和基线下的作者结果,不是所有设备的共同涨幅。

部署时还要看瓶颈在哪里

对本来受权重读取带宽限制的任务,减少搬运量可能很有效;如果主要时间消耗在其他计算、通信或请求调度上,同样的压缩比例就未必显眼。并发数、上下文长度和批处理方式改变后,瓶颈也会移动。

模型服务团队因此不能只比较两个文件的大小。还应在自己的请求分布下记录首个输出等待时间、持续生成速度、内存峰值和兼容性,并把权重格式转换、加载以及维护多套内核的成本算进去。平均吞吐提升但小请求延迟恶化,也可能是不合适的部署选择。

这项工作的价值,是把一个看似固定的“每权重多少比特”重新放回数据分布与机器实现中讨论。它没有发明一种普遍超越下界的魔法压缩,也没有证明更低比特必然带来更聪明的模型。

关键事实

  • 来源:2026 年 9 月 14 日提交的 BITCOS 预印本。
  • 技术对象:既有三值权重的存储布局与解包实现。
  • 数字边界:1.485 比特指最稀疏样本的权重符号部分;不是整机推理内存。
  • 验证范围:论文所测 CPU 与 Xe2 GPU,不代表全部硬件。

OC 判断

低比特模型的下一步竞争,不只在训练时把数值压小,也在运行时如何少搬数据、少做解包。BITCOS 提供了一个可检验的工程方向,实际收益仍应由目标设备上的完整工作负载决定。

为什么重要

  • 对开发者:选择权重格式时,应同时检查稀疏分布与运行内核支持。
  • 对模型服务商:把压缩率和端到端延迟放在同一张测试表里。
  • 对用户:更小的模型包值得期待,但不能据此推断回答质量或续航提升比例。

参考来源

相关阅读

基于标题、摘要和正文内容自动匹配。

更多科技

评论

围绕这篇文章补充信息、提出问题或分享观察。

0
暂无评论。

发表评论

继续看看 OC 用户围绕这个话题说了什么、做了什么。

相关碎碎念

更多

最近越来越多思考,我们跟agent的关系,比如我最近用blender mcp很多,基本上我算是会用blender的,但是老记不住很多热键,以前我可以做很复杂的模型,但是要是不是的去查blender的操作热键。现在我完全不参与模型的建模,只让codex帮我生成。 但是我还是在查blender的热键,我现在需要的是numpad .这样聚焦到一个对象的方法,我需要的是numpad /这样的方法来把除了选中的对象,其他都隐藏的热键。 换言之,我现在需要高效的人工视觉复检blender mcp的成果,这是我对自己目前blender能力的需求了。

tinyfool 2 0

帕格尼物语的任务全部打穿,然后开始玩社区创作的地图,这种游戏在建设的时候特别过瘾,建立起稳定的经济模型后也很过瘾,稳定下来观察小人的行为也很过瘾,然后如果没有外部矛盾,比如敌人侵略或者必须找到某种材料,等等的问题,就开始索然无味了。 人生其实也像这样的游戏,我曾经构建过几次自己的稳定架构,然后就索然无味,然后又因为抑郁,崩塌了,我在人生这个游戏最近感觉有有点动力不足,就是因为每次架构彻底崩塌才来重建,十分疲惫

tinyfool 0 1

因为青光眼辞职在家2个月,现在没压力眼药也减量了。这段时间为个人爱好做了个网站 birdwise.cc ,还发现运动里骑车最好坚持(共享单车骑起来特别满足好胜心)。不过更难的英语口语和开源社区贡献,目前进展很慢

gsavl 2 0

相关帖子

更多

你们的Codex额度提前耗完了没?戒断反应如何?

<p>我在第三天就消耗了只剩1%,忍了一天,然后今天干脆用这最后的1%,开着5.6 Sol 极高 强推我一个提示词笔记本应用的功能落地。最终用时3小时,居然还是跑完了。但是现在还是出现一些戒断反应,感觉啥也做不了,就无精打采的,困。</p> <p>我做了一个Prompt Notebook,专门用来收藏或者记录自己手搓的生图提示词。带Chrome一键收藏插件。支持AI优化提示词。支持提示词中提取常用字段作为提示词百科词汇。也自带生图功能用来测提示词。但是要搭配Cloudflare R2+Worker的图床。</p> <p>今天主要是做一个AI模特的资产库。将常用的AI模特固定下来,进行身份设定,以及模特的一些角色定妆图。之后生图可以直接调用AI模特自动作为垫图。</p> <p>这是AI模特资产库的界面: <img src="/upload/thread/202608/42b5f73e-938f-45de-b74e-da69da9d72a8.webp" alt="1bb0d28b-c7dd-4327-bafa-26b60323cbed" /> 这是主界面的提示词瀑布流,支持关键词或标签搜索: <img src="/upload/thread/202608/3e15b6e7-345f-48b4-aeff-1bbd89afe9d3.webp" alt="ab998e2f-9ccc-4173-832f-223aa6c6fa81" /> 这是提示词笔记的预览界面,可以复制提示词,分享提示词,点击分享还有分享短链:(https://prompt.jintao.co.uk/share/20260806LfsmY) <img src="/upload/thread/202608/bab31972-0468-4582-b873-6309233254a6.webp" alt="20260806-201213" /> 可惜现在没额度了,我又不想换模型折腾。现在还有些界面细节和小功能需要落地完善,可能还要虫子要抓。弄好了,打算放GitHub开源。</p> <p>有朋友想试试的么?</p>

shynloc 2 4

做 AI 语音产品时,授权、撤回和审计日志应该怎么落地?

<p>最近看到越来越多关于声音授权的讨论。对开发者来说,真正麻烦的往往不是“模型能不能模仿”,而是授权如何进入系统、生成结果如何追溯,以及授权撤回后该怎么办。</p> <p>我们在做 FlowSpeech 时也碰到过类似问题。我的体会是,不要把“用户勾选过同意”当成一个布尔字段,而应该把它做成一组可以审计的业务对象。</p> <h2>1. 把声音资产和授权分开</h2> <p>声音文件只描述技术属性,例如哈希、上传者、存储位置和创建时间。授权记录则至少要包含授权主体、用途范围、地域、有效期、来源证据和当前状态。这样同一份声音用于个人试听、商业广告、公开播客时,可以绑定不同的授权,而不是共用一个模糊的 consent=true。</p> <h2>2. 每次生成都保存授权快照</h2> <p>生成任务不要只引用当前授权 ID。授权内容以后可能变更,如果任务只查最新状态,历史结果就无法解释。更稳妥的做法是在任务创建时保存授权版本、文本哈希、声音版本、模型版本和操作者。生成出的音频再记录 artifact_id,并反向关联任务。</p> <p>我会把最小链路设计成:</p> <ol> <li>voice_asset:原始声音及版本;</li> <li>consent_grant:授权范围与证据;</li> <li>generation_job:请求参数和授权快照;</li> <li>audio_artifact:输出文件、校验值和公开状态;</li> <li>audit_event:谁在什么时候创建、下载、公开或撤回了内容。</li> </ol> <h2>3. 撤回不是简单删除一行</h2> <p>授权撤回后,系统至少要阻止新任务,并把相关公开音频进入下架队列。已经交付给客户的文件是否能删除,要按照合同和产品能力区分,不能在界面上承诺技术上做不到的“全球删除”。更现实的状态机是 active、suspended、revoked、expired,并明确每个状态允许哪些动作。</p> <h2>4. 对外展示也要可验证</h2> <p>除了后台日志,公开音频最好带上来源标记或可查询的生成记录。水印不是万能方案,但“可识别的音频 + 可验证的元数据 + 清晰的举报入口”组合起来,比一句“AI 生成”更有用。</p> <p>我们现在做的 <a href="https://flowspeech.io/zh">FlowSpeech</a> 主要解决上下文感知、情绪和停顿控制。越往产品化走,越觉得声音效果只是前半程,权限边界和可追溯性才决定这类工具能不能长期使用。</p> <p>大家在实际项目里会把授权证据放在业务数据库、对象存储,还是单独的审计系统?如果授权撤回,你们通常怎么处理已经生成并交付的音频?</p>

FlowSpeech 0 1

奉劝大家不要移民了

<p>对于大多数人而言,移民就是悲剧。实在看不下去了,大家不要往火坑里面跳。 国内发展那么快,你出国去慢车道,消费又高,又存不下钱,又要拼命适应当地环境,何苦? 老老实实在大城市找工作,根据收入买房子上车就好。</p> <p>补充:大城市觉得房价太高太辛苦,就好好学好英语,美国远程回老家省会城市,拿同比一线的收入,三线城市的开销,岂不美哉?</p> <p>转文章: <a href="https://mp.weixin.qq.com/s?__biz=MzAxNTMxMTc0MA==&amp;mid=2651016481&amp;idx=1&amp;sn=6bde227438ea02e3da3673295821692e&amp;chksm=80721b32b705922448a9f8645e8d1a8450e57151b71e58beb64e0addf9485ad0b256a431d68b&amp;mpshare=1&amp;scene=1&amp;srcid=0530QgwbtdDlMP4ZG7Nkonpo&amp;pass_ticket=bz%2FdHaz2YWQrgwhgQlVVXt866SMnyXU53Dd0OzDmMc1uZeu0PqND%2FjdQ6fQk8Bdl#rd"> 中产阶级的地雷阵 #D03 </a></p> <p>更多文章:<a href="https://mp.weixin.qq.com/s?__biz=MzAxNTMxMTc0MA==&amp;mid=503532389&amp;idx=1&amp;sn=84ff5eefb88e1b17f9ec0efb0238140d&amp;chksm=00721d76370594601903172e49477ce0ed149a3ba1bdcb88a300b55c8c552a79ea31134216ae&amp;mpshare=1&amp;scene=1&amp;srcid=0719VQx1dNX5rlraUqjWtCFm&amp;pass_ticket=bz%2FdHaz2YWQrgwhgQlVVXt866SMnyXU53Dd0OzDmMc1uZeu0PqND%2FjdQ6fQk8Bdl#rd">列表</a></p>

halida 198 9

一个体会,Codex 这种现代 Agent,每天一个变,几天不用就有新惊喜

<p>当然我说的也包括 Claude Code,新功能日新月异,还有就是 AI 能力提升以后,可以做的东西日新月异。还有各种工作流方法日新月异。</p> <p>更好玩的是,我最近经历过很多次,你跟人介绍现在 Codex 可以做到什么样子,他们都觉得很厉害。但是你现场一演示,他们的震撼就更加完全不同了。所以,这种东西,需要大量的 Workshop 去沟通交流,光看文字很难讲清楚,直播、视频也越来越重要了。</p>

tinyfool 1 89