Uber 给错误找归属,重试不该在每一层同时发生
Uber 工程团队的最新文章介绍了一套已经用于生产的“错误归属”机制:区分某个服务自己产生的故障与只是向上传递的故障,让重试集中在合适的位置。它针对的不是请求失败本身,而是每一层都想帮忙,最后一起压垮下游的连锁反应。
作者:林岚|OC 开发者生态编辑
Uber 工程团队的最新文章介绍了一套已经用于生产的“错误归属”机制:区分某个服务自己产生的故障与只是向上传递的故障,让重试集中在合适的位置。它针对的不是请求失败本身,而是每一层都想帮忙,最后一起压垮下游的连锁反应。
一句话结论:重试次数受控还不够,重试发生在哪一层也需要控制;错误来源和调用上下文是可靠性机制的一部分。
每层只多试一次,也可能越帮越忙
设想三个服务依次调用。最底层出现问题,中间层再试一次;上层看到失败,也把整个中间流程再试一次。局部设置都很克制,组合起来却可能让底层接到更多重复请求。
如果故障来自短暂波动,重试有机会成功;如果来自持续过载,新增请求会占用更多资源,让恢复更困难。问题不在“重试一定不好”,而在于失败并不总是独立、随机且马上可恢复的。
重试预算能限制一个服务额外制造多少流量,但多个服务分别持有预算时,整体仍可能放大。每个局部都守规矩,不保证整条调用链承受得住。
区分原因与症状
Uber 的思路是让基础设施判断:一个返回错误的服务,是自己出了问题,还是因为某个必要的下游调用失败。如果只是传递下游故障,就不应自动触发所有上游再次执行同一条失败路径。
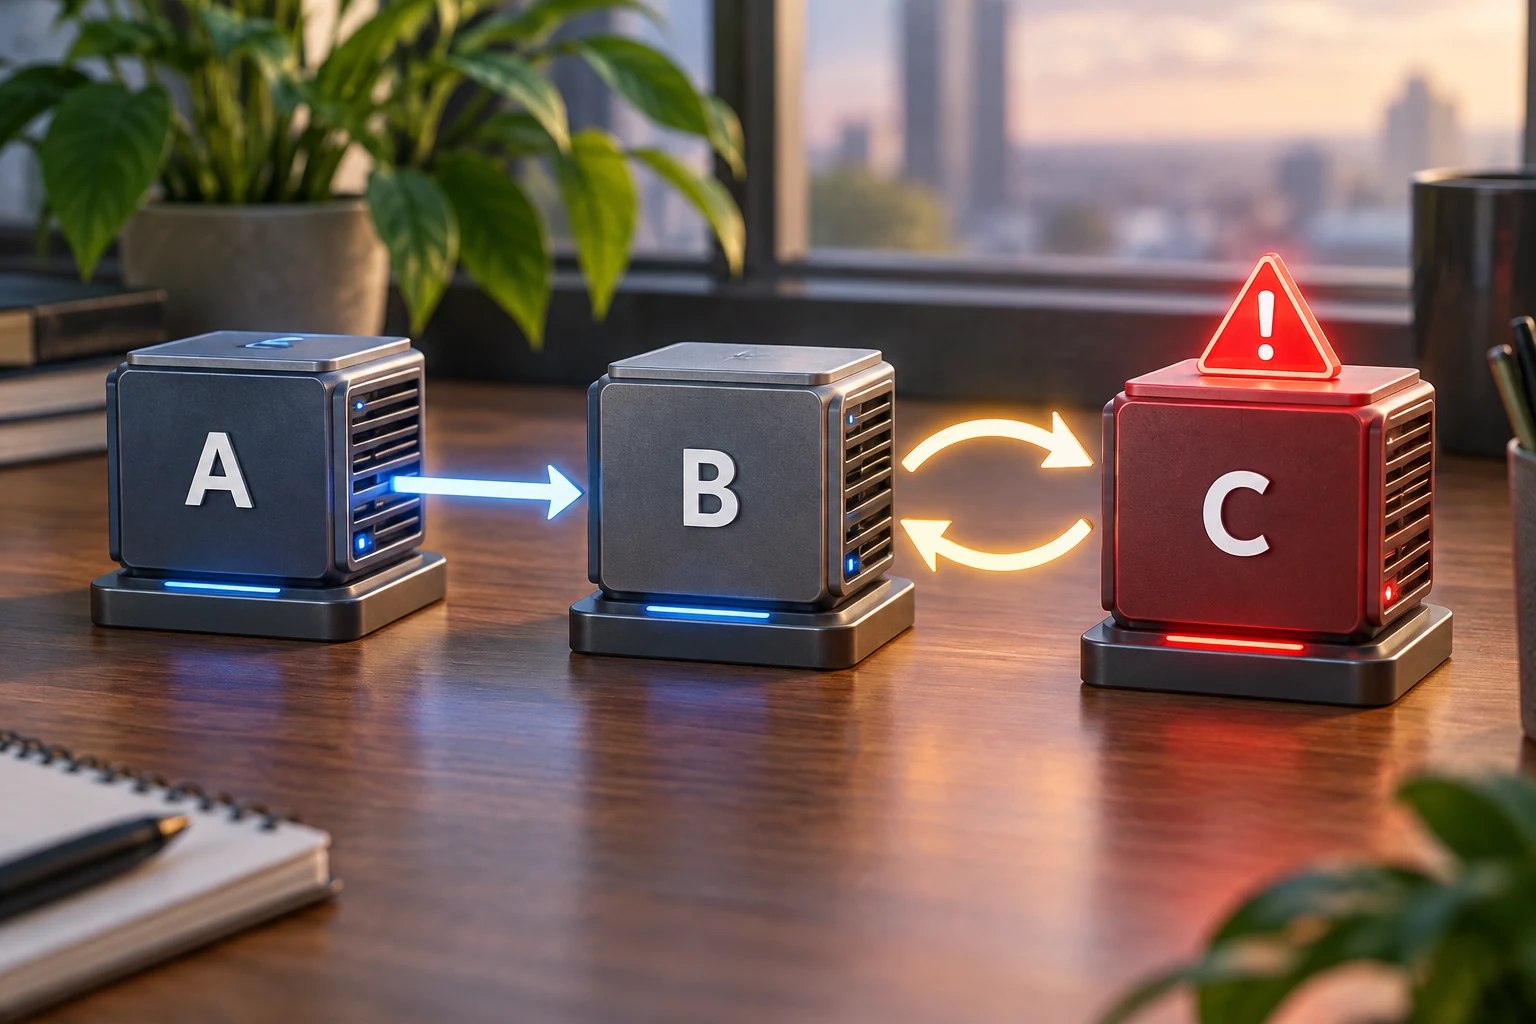
例如 C 产生错误,B 可以在规则和预算允许时重试 C;如果仍然失败,B 向 A 返回错误时说明这不是自己产生的故障,避免 A 再把 B 整段流程重跑。这里的归属是一种技术上下文,不是给团队追责的标签。
它依赖调用关联信息。只有知道哪些下游请求属于当前上游请求,才有机会区分真正原因与恰巧同时发生的失败。若一个可忽略的依赖失败,却被误当成整体失败原因,就可能压掉原本有用的重试。
上下文丢了,保护也会变弱
分布式追踪与上下文传播经常被当作排障设施。在这套机制中,它们还影响运行时决策:关联断开,服务可能把传来的错误误认成自己产生的错误,从而在更多层允许重试。
因此,不能只接入一个中间件就假定工作完成。部署后还需要观察上下文丢失、错误归属变化,以及哪些调用链缺少必要信息。缺失信息时采取什么策略,也应有明确设计。
Uber 还处理了另一种边界:如果最靠近故障的位置没有配置重试,简单禁止全部上游重试,可能牺牲恢复机会。其机制传递重试条件是否已满足的信号,但不会凭空为原本整条链都没配置重试的请求增加重试。
这说明可靠性设计不能只追求流量最低。减少无效请求与保留合理恢复机会,要在同一套规则里协调。
生产结果不是“故障从此不会扩散”
文章回顾的是 2025 年 11 月的一次生产事故,并报告抑制了大量潜在重复请求;不是宣布今天才发生一次同样规模的故障。其“重试风暴半径”也是特定调用图指标,不能读成所有故障传播都被限制在固定层数。
实际服务还有超时、取消、幂等性和降级等问题。对会产生副作用的操作,重复执行是否安全尤其重要;错误归属不会替业务自动解决重复扣款或重复创建记录。
更普遍的启示是:重试策略需要全链路视角。平台团队应该知道谁已经尝试过、还剩多少时间、下游能否恢复,而不是让每一层看到错误都重新开始一次自己的努力。
关键事实
- 来源:Uber 工程团队生产实践说明。
- 核心机制:区分本地产生与向上传播的错误,约束重试位置。
- 依赖条件:调用关联、上下文传播及已有重试配置。
- 数字边界:调用图中的重试半径,不等于全部故障的影响范围。
OC 判断
重试是一种消耗资源的恢复动作,不是免费的保险。Uber 的方案把“是否值得再试”从单个服务的配置,推进到调用链共同理解的上下文。
为什么重要
对开发者,错误传播应保留有用信息;对平台团队,观测能力可以直接参与保护系统。对用户,真正重要的是故障时少等待、能恢复,而不是后台尝试次数更多。


评论
围绕这篇文章补充信息、提出问题或分享观察。