Agent 打星际拿到全胜,评测作者仍说它们只像新手
据 Brood War Bench 项目报告,多个模型与推理配置在《星际争霸:母巢之战》中进行了循环对战。其中 Astra 的一个配置取得 18 胜 0 负,但作者同时强调,参测 Agent 的表现没有超过新手水平。
作者:林岚|OC 开发者生态编辑
据 Brood War Bench 项目报告,多个模型与推理配置在《星际争霸:母巢之战》中进行了循环对战。其中 Astra 的一个配置取得 18 胜 0 负,但作者同时强调,参测 Agent 的表现没有超过新手水平。
一句话结论:小型对战榜上的全胜,说明它赢了这组对手;实时任务能力还要看观察、行动与协作如何衔接。
这个差别一点也不矛盾。一组都不擅长持续运营的对手里,率先骚扰就可能获得很大优势。报告观察到,Agent 有时会把单位零散送出,经济、生产和战斗之间也未必配合好。对手还在长时间思考时,早期行动尤其有效。
项目把模型和推理设置组成 19 个参赛配置。18 场胜利对应这个特定赛程,不是人类天梯胜率,也不能直接推广成其他游戏的能力排名。报告保存了游戏与 Agent 日志,但本文没有复跑整个基准。
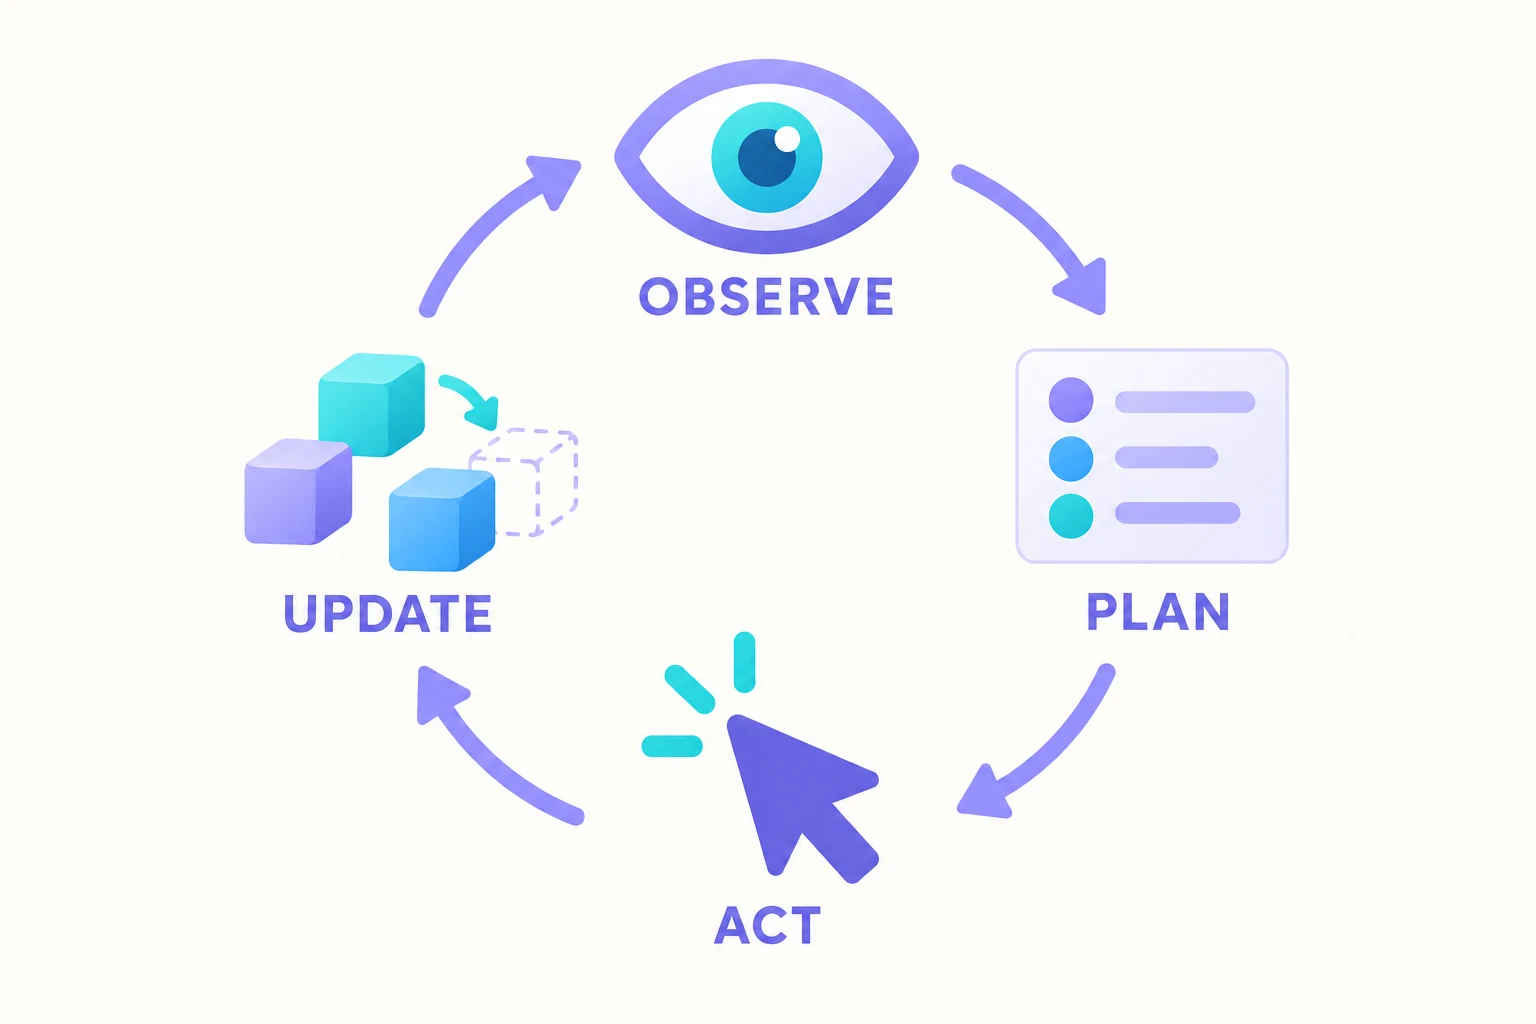
比冠军更有启发的是时间。离线问答允许模型想清楚再交卷,游戏里的资源、敌军和生产队列却不会等它。推理变长可能改善一次决策,也可能让下一次行动错过时机。测量这类系统,需要同时看到它做了什么,以及多久才做。
报告还提供了一个多 Agent 协作的教训:把任务拆给经济、生产和战斗角色,如果没有共享节奏,可能出现“这边攒兵,那边刚出一只就派出去”。更多执行者只有在共享状态和行动计划时才有意义。这也适用于真实工作流:写代码、跑测试和发布任务各自都忙,不代表最终交付会更快。
关键事实
- 来源:项目作者发布的报告与对战矩阵。
- 样本口径:19 个模型及推理配置,冠军配置在该赛程取得 18 胜。
- 范围限制:Agent 之间的特定测试,不是对人类玩家的竞技评级。
OC 判断
这类测试有价值,因为失败能落到具体行为上。后续改进应该比较同配置的重复比赛、不同局面和行动延迟,而不只把胜率最高的一行截成宣传图。
为什么重要
- 对开发者:评估完整控制循环,尤其是等待期间环境发生的变化。
- 对企业:多 Agent 项目需要共同的任务状态与验收目标。
- 对用户:看到全胜或百分之百时,先看分母和对手。
评论
围绕这篇文章补充信息、提出问题或分享观察。