OC
Opus 5.5 降价,40%的任务成本降幅并非所有 token 都便宜四成
科技 · 2026-09-23 · AI 模型 · 阅读 0

Opus 5.5 降价,40%的任务成本降幅并非所有 token 都便宜四成

Anthropic 在Opus 5.5 发布页宣布,新模型输入和输出价格分别为每百万 token 4美元、20美元,较 Opus 5 低20%;缓存读取为0.20美元,下降60%。公司另称,默认设置下典型任务总成本下降约40%。

作者:林岚|OC 开发者生态编辑

Anthropic 在Opus 5.5 发布页宣布,新模型输入和输出价格分别为每百万 token 4美元、20美元,较 Opus 5 低20%;缓存读取为0.20美元,下降60%。公司另称,默认设置下典型任务总成本下降约40%。

一句话结论:单价、缓存折扣与任务用量共同决定成本,厂商给出的总降幅不能直接套到每个应用。

三个降幅并不矛盾:输入、输出和缓存读取各有价格,一次任务又可能使用不同数量的 token。缓存占比较高的编码工作,与只有短提示的新会话,不会得到同样的节省。

发布页同时披露,部分生物与网络安全任务触发防护后会交给其他模型处理,基准脚注也说明了回退的存在。这意味着评测结果需要结合实际运行路径理解,不能一概视为单一模型在所有题目上的裸能力。
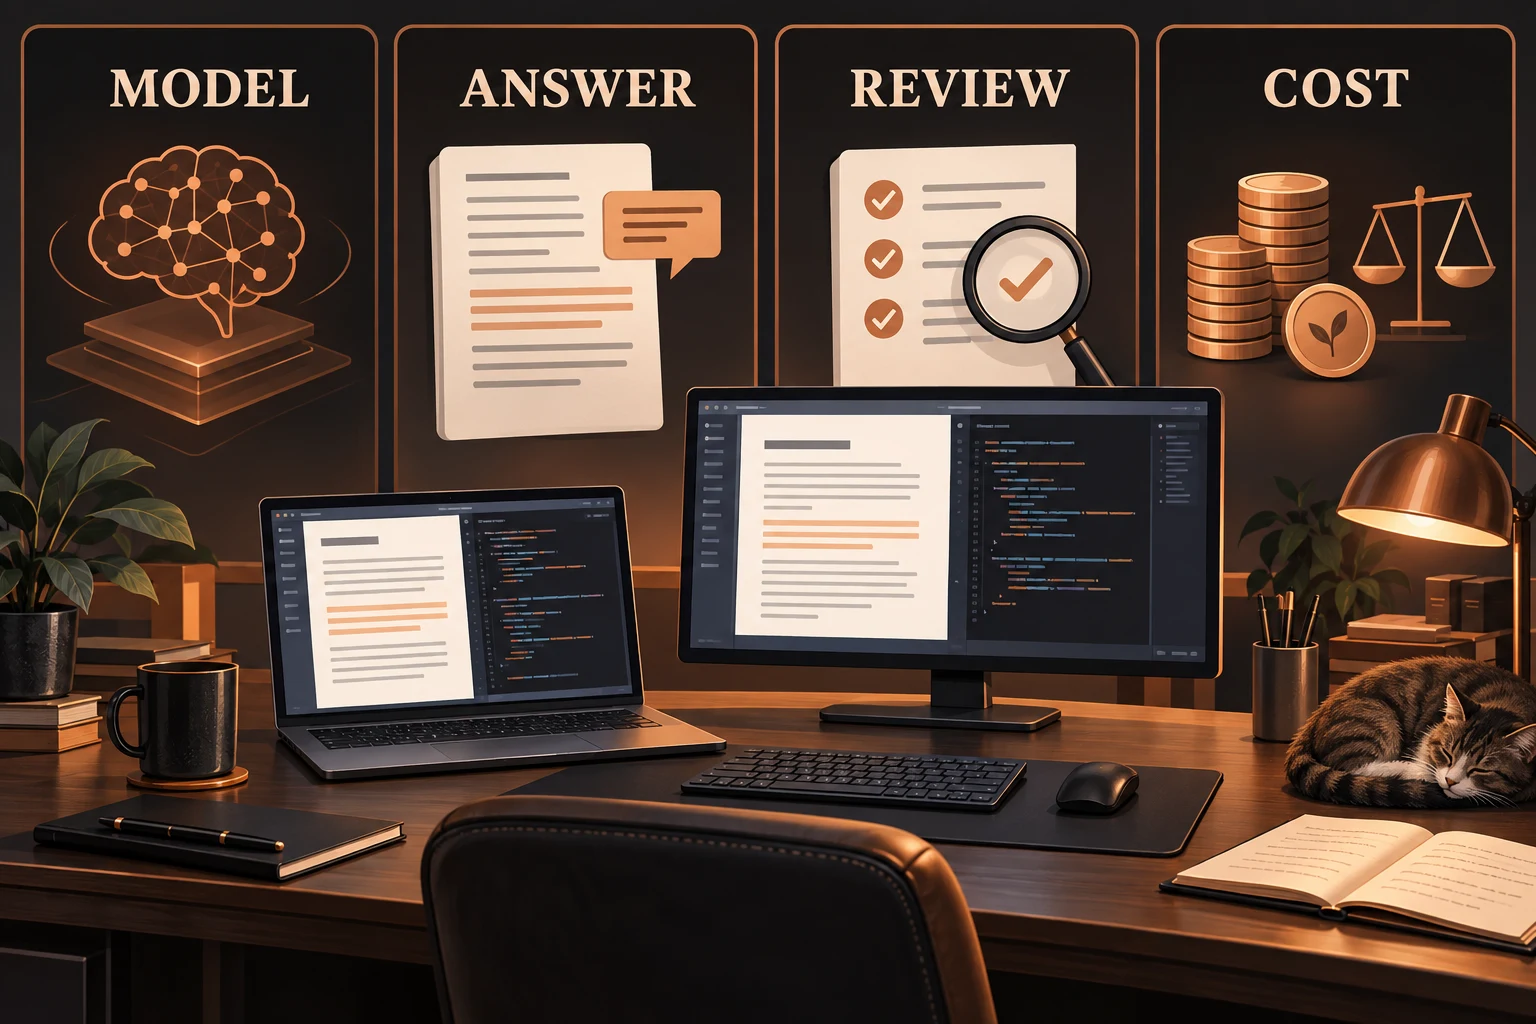
模型、回答、复核与成本的四项检查(AI 生成示意)

OC 认为,这次升级值得同时测试两件事:结果能否减少返工,回答是否更容易检查。文字更清楚有实际价值,但不能取代代码测试、事实来源与权限记录。把表达自然当成可靠性证明,容易让看起来合理的错误漏过审查。

团队若准备切换,宜保留同一批复杂任务的旧版结果,记录缓存命中、输出量、运行耗时和验收失败。测试也应覆盖模型拒绝或回退后的体验:用户是否知道任务状态,工作流是否能正确处理差异。

关键事实

  • 价格:每百万输入4美元、输出20美元、缓存读取0.20美元。
  • 40%口径:Anthropic 对默认设置下典型任务总成本的测算。
  • 评测边界:发布方基准包含安全防护及部分模型回退,非独立复测。

OC 判断

降价最有意义的结果,是同一预算能够完成更多合格工作。厂商的平均数提供了测试理由,团队自己的任务分布才决定节省多少。采购时应把质量、延迟和失败处理放在同一张账上。

为什么重要

  • 对开发者:分别记录缓存、输入、输出及重试开销。
  • 对团队:核对任务中的安全回退行为,不把榜单分数当作所有工作流的保证。

参考来源

相关阅读

基于标题、摘要和正文内容自动匹配。

更多科技

评论

围绕这篇文章补充信息、提出问题或分享观察。

0
暂无评论。

发表评论

继续看看 OC 用户围绕这个话题说了什么、做了什么。

相关帖子

更多

你们的Codex额度提前耗完了没?戒断反应如何?

<p>我在第三天就消耗了只剩1%,忍了一天,然后今天干脆用这最后的1%,开着5.6 Sol 极高 强推我一个提示词笔记本应用的功能落地。最终用时3小时,居然还是跑完了。但是现在还是出现一些戒断反应,感觉啥也做不了,就无精打采的,困。</p> <p>我做了一个Prompt Notebook,专门用来收藏或者记录自己手搓的生图提示词。带Chrome一键收藏插件。支持AI优化提示词。支持提示词中提取常用字段作为提示词百科词汇。也自带生图功能用来测提示词。但是要搭配Cloudflare R2+Worker的图床。</p> <p>今天主要是做一个AI模特的资产库。将常用的AI模特固定下来,进行身份设定,以及模特的一些角色定妆图。之后生图可以直接调用AI模特自动作为垫图。</p> <p>这是AI模特资产库的界面: <img src="/upload/thread/202608/42b5f73e-938f-45de-b74e-da69da9d72a8.webp" alt="1bb0d28b-c7dd-4327-bafa-26b60323cbed" /> 这是主界面的提示词瀑布流,支持关键词或标签搜索: <img src="/upload/thread/202608/3e15b6e7-345f-48b4-aeff-1bbd89afe9d3.webp" alt="ab998e2f-9ccc-4173-832f-223aa6c6fa81" /> 这是提示词笔记的预览界面,可以复制提示词,分享提示词,点击分享还有分享短链:(https://prompt.jintao.co.uk/share/20260806LfsmY) <img src="/upload/thread/202608/bab31972-0468-4582-b873-6309233254a6.webp" alt="20260806-201213" /> 可惜现在没额度了,我又不想换模型折腾。现在还有些界面细节和小功能需要落地完善,可能还要虫子要抓。弄好了,打算放GitHub开源。</p> <p>有朋友想试试的么?</p>

shynloc 2 4

一个体会,Codex 这种现代 Agent,每天一个变,几天不用就有新惊喜

<p>当然我说的也包括 Claude Code,新功能日新月异,还有就是 AI 能力提升以后,可以做的东西日新月异。还有各种工作流方法日新月异。</p> <p>更好玩的是,我最近经历过很多次,你跟人介绍现在 Codex 可以做到什么样子,他们都觉得很厉害。但是你现场一演示,他们的震撼就更加完全不同了。所以,这种东西,需要大量的 Workshop 去沟通交流,光看文字很难讲清楚,直播、视频也越来越重要了。</p>

tinyfool 1 89

做 AI 语音产品时,授权、撤回和审计日志应该怎么落地?

<p>最近看到越来越多关于声音授权的讨论。对开发者来说,真正麻烦的往往不是“模型能不能模仿”,而是授权如何进入系统、生成结果如何追溯,以及授权撤回后该怎么办。</p> <p>我们在做 FlowSpeech 时也碰到过类似问题。我的体会是,不要把“用户勾选过同意”当成一个布尔字段,而应该把它做成一组可以审计的业务对象。</p> <h2>1. 把声音资产和授权分开</h2> <p>声音文件只描述技术属性,例如哈希、上传者、存储位置和创建时间。授权记录则至少要包含授权主体、用途范围、地域、有效期、来源证据和当前状态。这样同一份声音用于个人试听、商业广告、公开播客时,可以绑定不同的授权,而不是共用一个模糊的 consent=true。</p> <h2>2. 每次生成都保存授权快照</h2> <p>生成任务不要只引用当前授权 ID。授权内容以后可能变更,如果任务只查最新状态,历史结果就无法解释。更稳妥的做法是在任务创建时保存授权版本、文本哈希、声音版本、模型版本和操作者。生成出的音频再记录 artifact_id,并反向关联任务。</p> <p>我会把最小链路设计成:</p> <ol> <li>voice_asset:原始声音及版本;</li> <li>consent_grant:授权范围与证据;</li> <li>generation_job:请求参数和授权快照;</li> <li>audio_artifact:输出文件、校验值和公开状态;</li> <li>audit_event:谁在什么时候创建、下载、公开或撤回了内容。</li> </ol> <h2>3. 撤回不是简单删除一行</h2> <p>授权撤回后,系统至少要阻止新任务,并把相关公开音频进入下架队列。已经交付给客户的文件是否能删除,要按照合同和产品能力区分,不能在界面上承诺技术上做不到的“全球删除”。更现实的状态机是 active、suspended、revoked、expired,并明确每个状态允许哪些动作。</p> <h2>4. 对外展示也要可验证</h2> <p>除了后台日志,公开音频最好带上来源标记或可查询的生成记录。水印不是万能方案,但“可识别的音频 + 可验证的元数据 + 清晰的举报入口”组合起来,比一句“AI 生成”更有用。</p> <p>我们现在做的 <a href="https://flowspeech.io/zh">FlowSpeech</a> 主要解决上下文感知、情绪和停顿控制。越往产品化走,越觉得声音效果只是前半程,权限边界和可追溯性才决定这类工具能不能长期使用。</p> <p>大家在实际项目里会把授权证据放在业务数据库、对象存储,还是单独的审计系统?如果授权撤回,你们通常怎么处理已经生成并交付的音频?</p>

FlowSpeech 0 1

你在用 Codex 的什么套餐,我是100美金的,已经想升级了

<p>你们呢?</p> <p>我最近主要是做了很多 Blender mcp 的事情,感觉效果很好,当然同时也很耗费 Token</p>

tinyfool 6 235