Tailscale 从缓冲区和队列提速,多核收益要看实际流量
据 Tailscale 工程博客,团队正在调整数据包缓冲区、队列和多核处理方式,以改善性能和内存使用。
作者:林岚|OC 开发者生态编辑
据 Tailscale 工程博客,团队正在调整数据包缓冲区、队列和多核处理方式,以改善性能和内存使用。
一句话结论:这轮改进针对数据在机器里怎样移动,收益取决于平台、负载与版本。
网络工具的瓶颈未必都在加密算法或线路带宽上。数据包进入用户态后如何分配内存、要复制几次、在哪个 CPU 上排队,同样会影响系统能处理多少流量。
Tailscale 举出的一个例子是小数据包占用较大的缓冲区。新的实现让多个数据片段通过同一缓冲区的视图来处理,减少不必要的复制和空间占用。公司给出的部分配置测试出现约 5% 的吞吐改善,但这只是特定优化在特定条件下的测量,不能作为所有设备升级后的承诺。
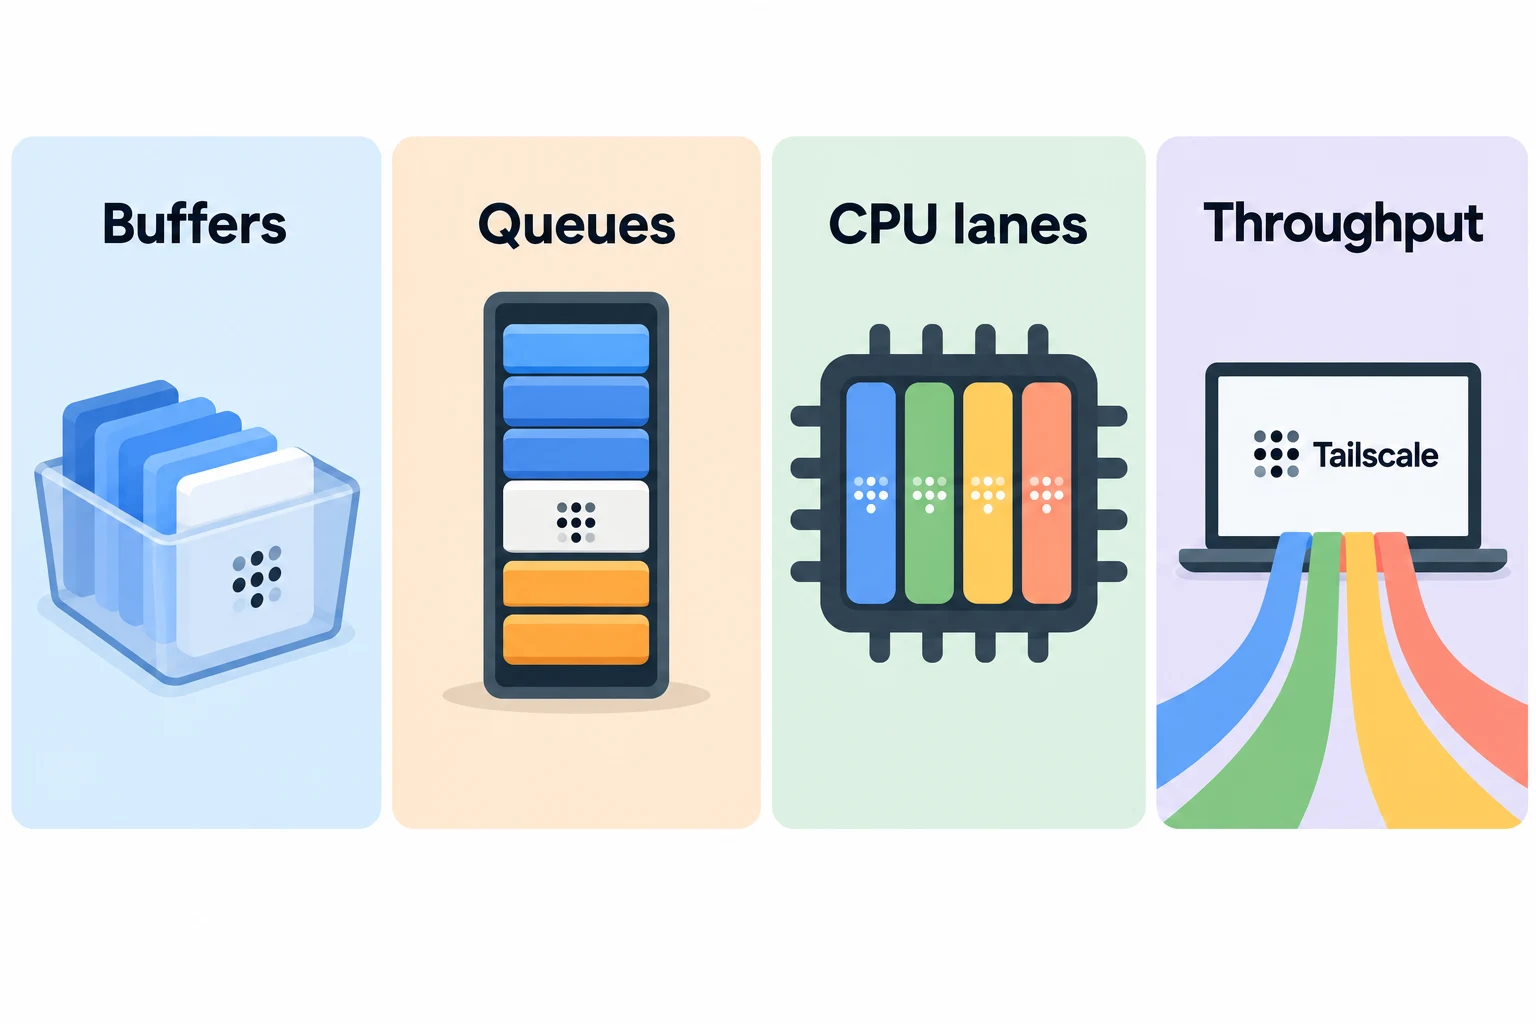
另一个方向是多队列。对于子网路由器、出口节点等承载许多连接的机器,让不同流分担到多个处理通道,可以更充分地使用多核 CPU。同一条流仍需保持合适的处理顺序,因此机器的总吞吐增加,不意味着单个下载也按核心数成倍加速。
官方将相关多队列工作列入 2026 年下半年,并提到后续稳定版本。管理员需要核对实际安装版本和功能状态,不能把工程路线图当成已经全面交付的功能。
OC 更建议以具体角色测量:笔记本轻负载关注空闲内存和耗电,出口节点关注多连接总吞吐,交互应用关注延迟和丢包。用一个跑满带宽的数字覆盖所有设备,反而容易漏掉真正影响体验的变化。
关键事实
- 来源:Tailscale 工程说明,性能数字来自厂商。
- 改动方向:缓冲区、队列长度与多核处理。
- 可用性:部分工作仍对应后续稳定版本,需逐项核对。
OC 判断
这类优化的价值在于把成本落到可解释的处理路径上。采购更强机器之前,先看现有 CPU 是否被单队列限制;发布升级之前,再确认吞吐改善没有以延迟和内存回升为代价。
为什么重要
- 对开发者:区分内存复制、排队和线路带宽三类瓶颈。
- 对企业:按路由角色和并发连接重做容量评估。
- 对用户:个别吞吐测试不能代表所有网络体验。
评论
围绕这篇文章补充信息、提出问题或分享观察。