Jev 的置信度引发校准讨论,一个小数还不能直接决定业务放行
据 Alex Molas 9 月 23 日文章,针对 Jev 输出置信度的讨论需要回到任务分布:分数在什么样的数据上经过验证,比它看起来多精确更重要。
作者:林岚|OC 开发者生态编辑
据 Alex Molas 9 月 23 日文章,针对 Jev 输出置信度的讨论需要回到任务分布:分数在什么样的数据上经过验证,比它看起来多精确更重要。
一句话结论:模型给出 0.9,并不自动意味着你这项业务里的同类判断有九成正确。
此前 OC 报道 Jev 时,重点是类型化输出如何进入程序,以及类型正确为何不能保证判断正确。这次新增的问题,是开发者准备把置信度直接用于放行、拒绝或升级人工处理时,阈值是否有可用的经验依据。
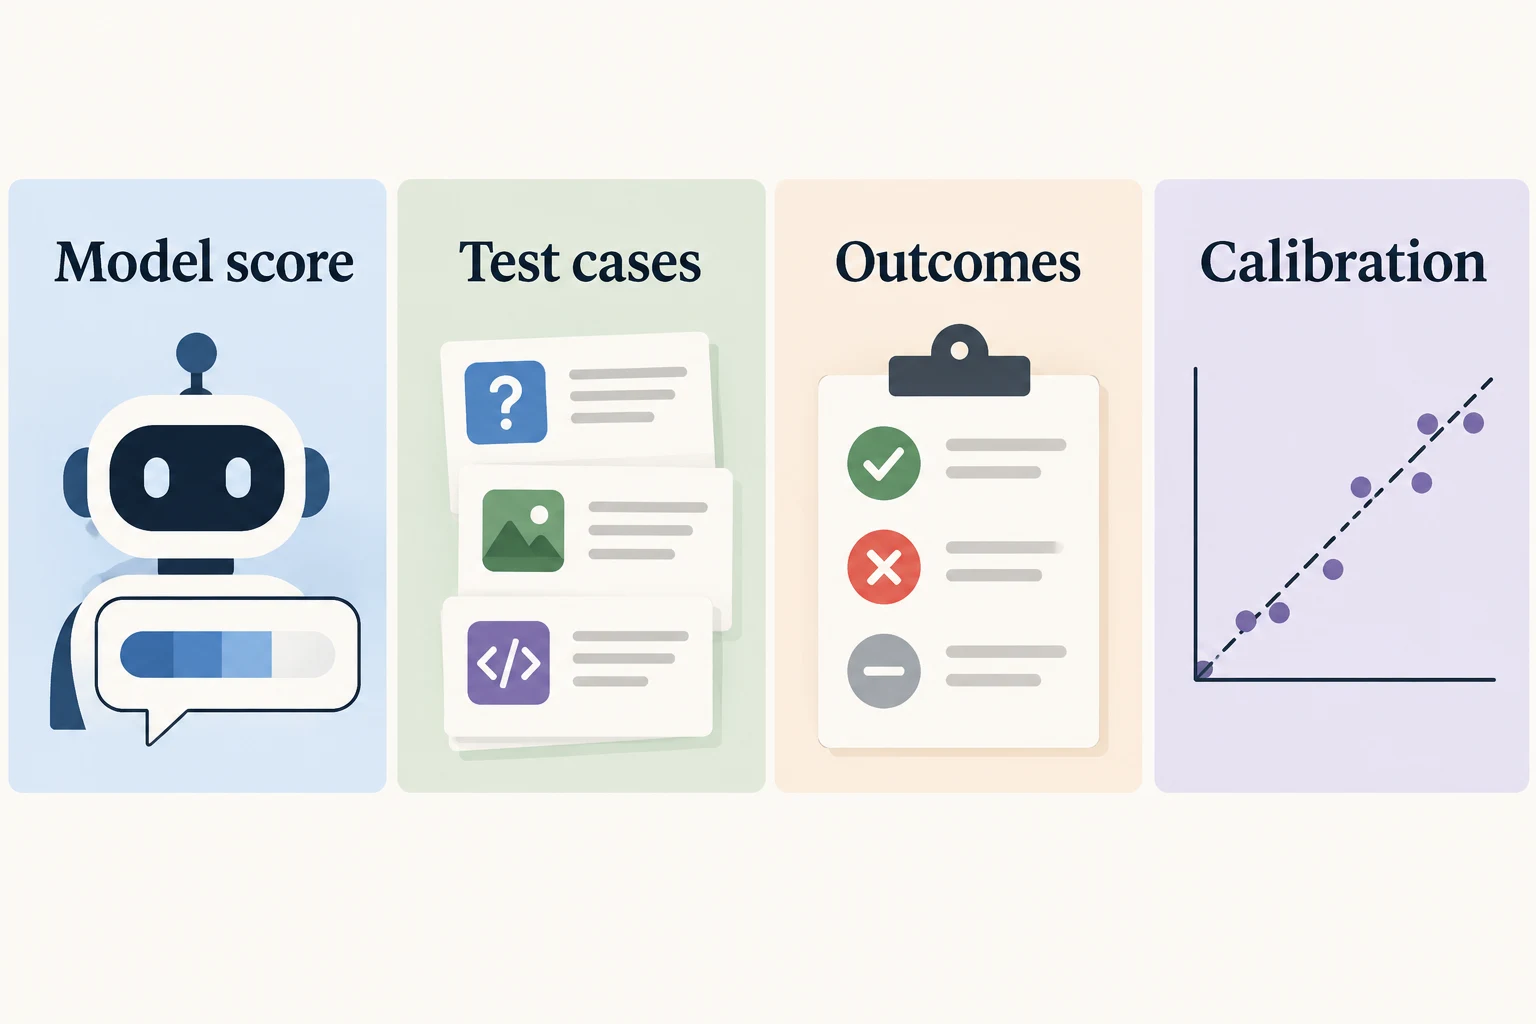
校准讨论的是一组预测与实际结果的对应关系。比如把声称具有相近把握的预测放在一起,看它们最终有多少成立。单个案例里的自信或失误,都不足以独立证明整个系统已经校准或完全无法校准。
Molas 文章标题措辞强烈,但正文更值得保留的限定是:校准依赖目标分布。把某类问题上的验证结果带到另一类问题,输入变化和结果定义变化都可能使原有映射失效。因此,不能把这篇评论写成“任何 Jev 系统都在数学上不可能校准”的定论。
对业务系统来说,第一步应是定义什么叫正确。客服分流是最终部门是否合适,风控复核是后续证据是否支持,代码迁移则可能需要一整套行为验证。不同任务不能靠同一条 0.8 阈值线省略定义。
分数也可以只用于排序:先把更值得人工看的案例排到前面。这与声称它是真实错误概率是两种用法。上线后若输入人群、提示或模型版本发生变化,阈值还应重新检查。
关键事实
- 来源:Alex Molas 的技术评论。
- 新增视角:置信度在目标任务分布中的可解释性。
- 证据限制:不把社交媒体个例当作独立复现实验。
OC 判断
一个适合写进 if 语句的小数,很容易让人忽略它背后的证据成本。真正可用的阈值需要真实任务样本、清楚的结果标签与持续观察;格式整齐只能减少接线工作,不能省掉这些验证。
为什么重要
- 对开发者:先区分排序分数与概率承诺。
- 对企业:把误放和误拒成本纳入阈值选择。
- 对用户:重要决定应提供复核路径。
评论
围绕这篇文章补充信息、提出问题或分享观察。