牛津历史文献进入 OpenAI 训练集,图书馆合作需要先说清数据用途
《卫报》根据牛津大学内部文件报道,Bodleian 图书馆与 OpenAI 的数字化合作不仅用于开放馆藏,扫描内容也被用于扩充模型训练集。牛津称材料规模有限、均已脱离版权保护,并会在未来数月公开上线。
作者:沈南乔|OC 社会影响编辑
《卫报》根据牛津大学内部文件报道,Bodleian 图书馆与 OpenAI 的数字化合作不仅用于开放馆藏,扫描内容也被用于扩充模型训练集。牛津称材料规模有限、均已脱离版权保护,并会在未来数月公开上线。
一句话结论:公共领域解决了部分版权问题,却没有自动解决合作披露、数据选择和公共机构信誉问题。
牛津 2025 年公布五年合作时,重点介绍了扫描公共领域馆藏和为师生提供工具。公开公告没有直接写明内容将进入 OpenAI 训练集。通过信息公开请求获得的会议记录则提到训练用途,以及校内人员对声誉和能源影响的担忧。
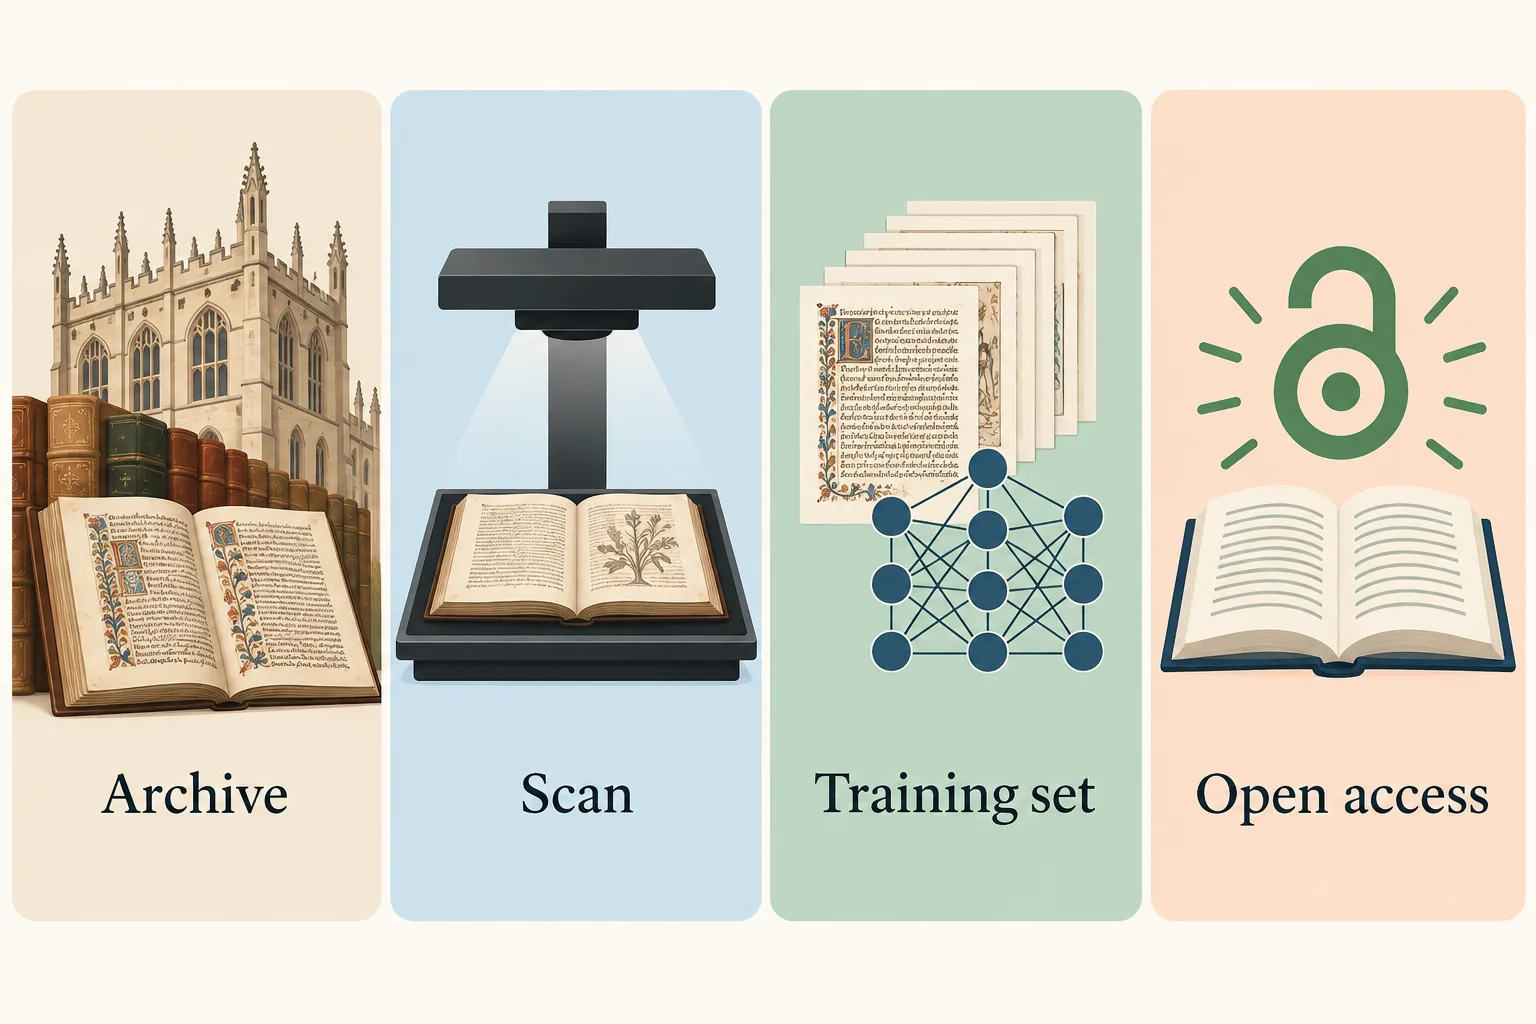
报道说,截至 2025 年 6 月,项目已向 OpenAI 共享约 12.5 万张历史论文影像,还涉及约 1 万份 16 世纪街头歌谣。牛津回应称,OpenAI 的使用是非独家的,图书馆保留扫描件权利,并将把材料公开给研究者和公众。学校也否认刻意隐藏机器学习用途。
这组安排同时产生公共收益与治理问题。稀有文献得到数字化、检索和开放访问,模型也获得互联网上稀缺的高质量材料。合作方因此更应在启动时清楚列出训练、检索、产品展示和再分发等用途,而不是让公众从内部记录补齐关键目的。
关键事实
- OpenAI 为 Bodleian 的规模化数字化研究提供资金。
- 内部文件显示,部分扫描材料被用于模型训练集。
- 牛津称内容为公共领域、非独家使用,并保留扫描件权利。
- 图书馆计划把数字化材料公开上线。
OC 判断
争议不在于公共领域材料绝对不能训练,而在于大学公开说明是否覆盖了关键用途。公共文化机构应公布材料范围、选择标准、合作方权利、开放时间和退出机制。
为什么重要
- 对图书馆:技术资金可以加速数字化,也会改变馆藏的商业用途。
- 对研究者:开放扫描件能扩大访问,但需要稳定许可和出处信息。
- 对模型公司:高质量训练数据合作必须经得起公开审查。

评论
围绕这篇文章补充信息、提出问题或分享观察。