TLA+ 被 AI 编程重新带火,模型检查先找设计错误,不是替代码盖章
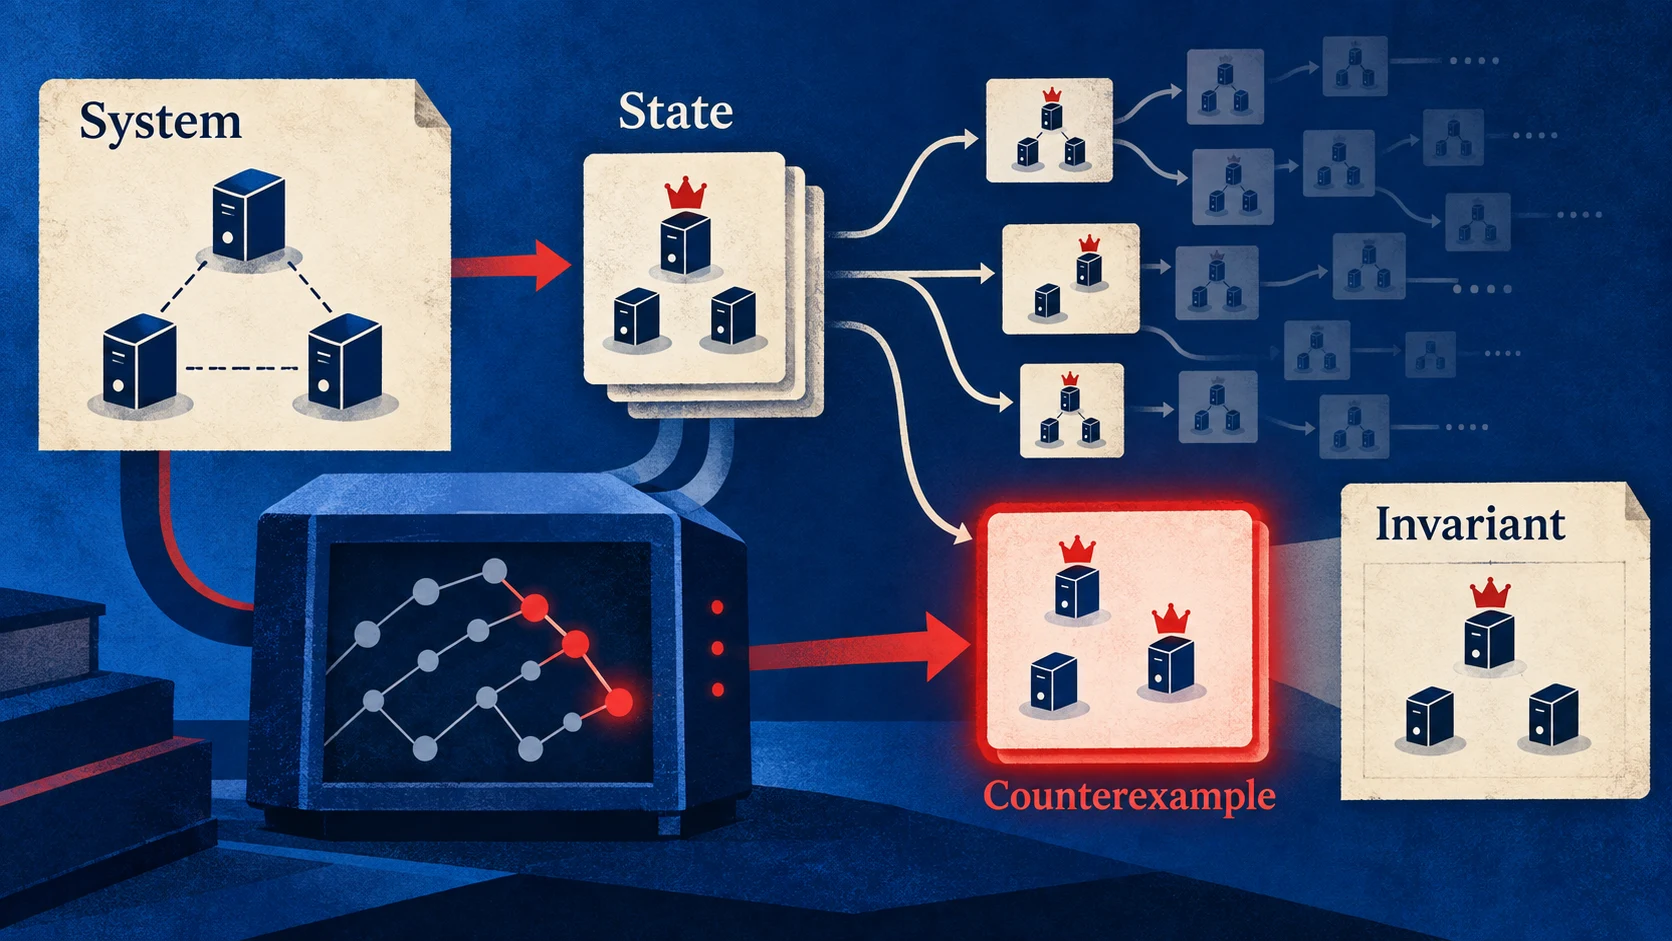
Anthropic 工程师用模型协助为 Claude Agent SDK 编写 TLA+ 与 Lean 规格后,这套三十多年历史的形式化方法再次受到关注。TLA+ 用状态、动作和时间性质描述系统允许发生什么;TLC 模型检查器会枚举有限实例的可达状态,寻找违反安全性或活性的执行路径。
作者:林岚|OC 开发者生态编辑
Anthropic 工程师用模型协助为 Claude Agent SDK 编写 TLA+ 与 Lean 规格后,这套三十多年历史的形式化方法再次受到关注。TLA+ 用状态、动作和时间性质描述系统允许发生什么;TLC 模型检查器会枚举有限实例的可达状态,寻找违反安全性或活性的执行路径。
一句话结论:TLA+ 适合在写代码前发现并发与分布式设计错误,但检查通过的是模型,不是自动证明真实实现无错。
以三节点选举为例,安全性可以写成“任何时刻都不会有两个领导者”。若把规则改成允许节点重复投票,模型检查器能返回一条六步反例。活性则回答“最终是否会选出领导者”;一个永远不动作的系统可能很安全,却没有实际用途,因此还要明确公平性假设。
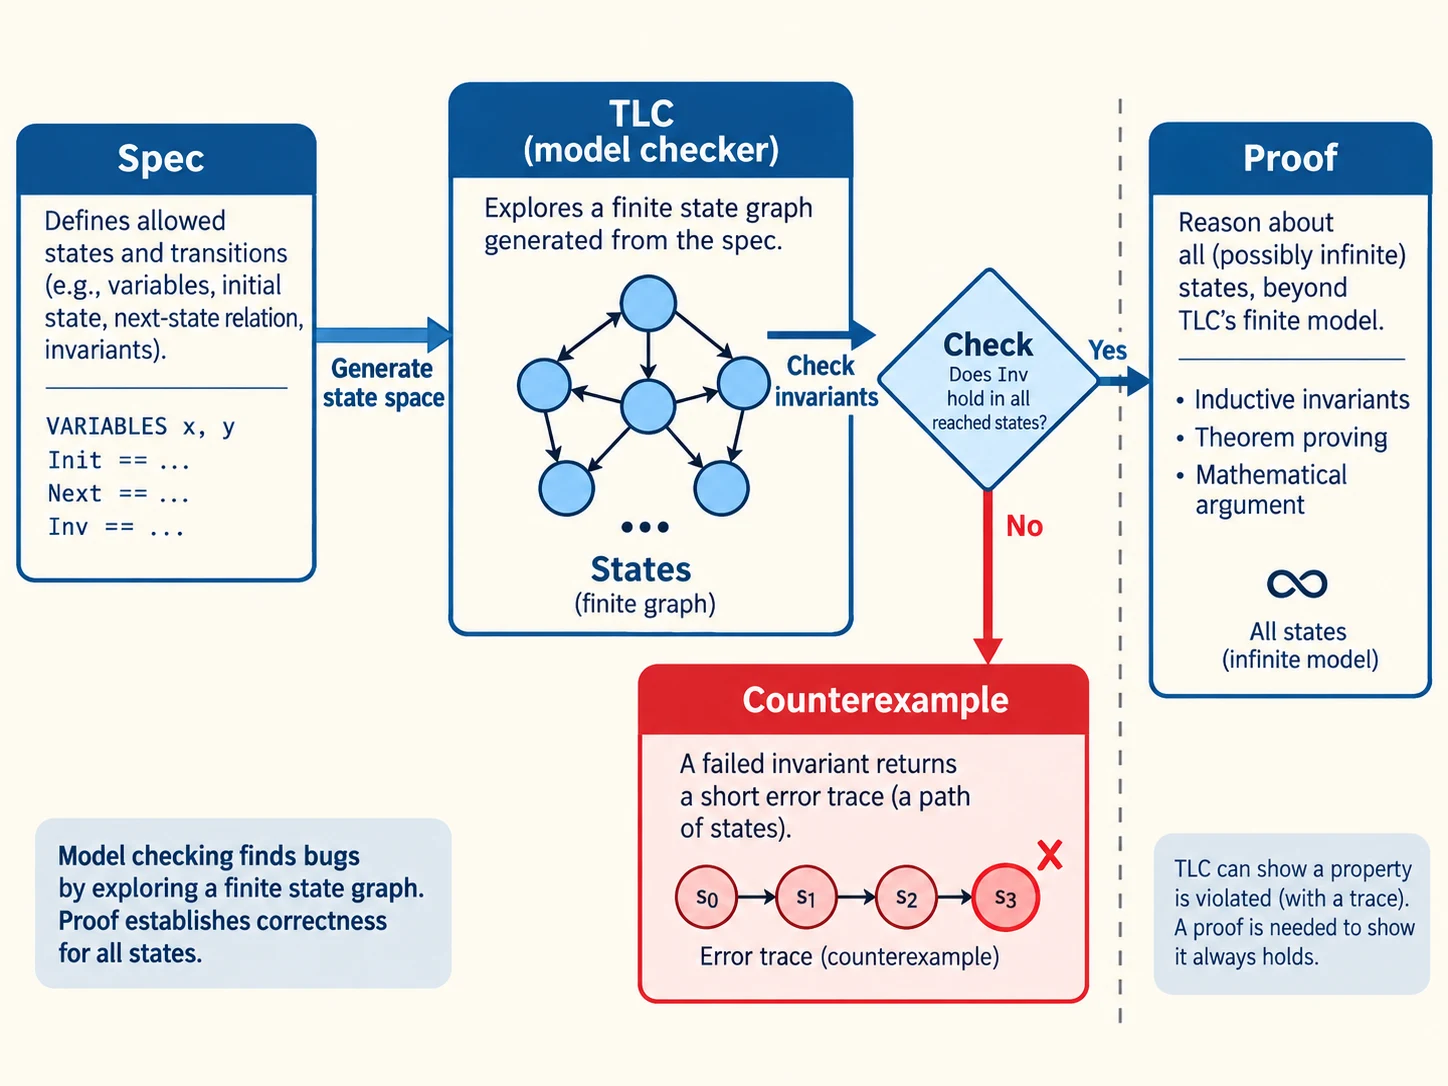
边界同样关键。TLC 只探索有限模型,状态空间会迅速增长;规格与代码分开维护时还会漂移。原文团队把 16459 组 TLA+ 规格与性质转入自动流水线,得到 3000 多个机器检查的 Verus 证明,但这仍是团队自报结果。AI 能补重复证明步骤,不能替团队决定规格是否写对。
关键事实
- 来源:Reasonable 教程与 Leslie Lamport 的 TLA+ 文档
- 涉及工具:TLA+、TLC、TLAPS、Lean、Verus
- 核心技术:状态机、安全性、活性、模型检查
- 关键数字:三节点示例有 38 个状态;九节点可超过一百万状态
OC 判断
AI 让写规格和证明的门槛下降,最有价值的结果仍是团队被迫把“永远不能发生什么”说清楚。形式化模型应该补充测试和实现审计,而不是成为认证贴纸。
为什么重要
- 对开发者:复杂并发问题可以在实现前得到具体反例。
- 对企业:关键系统的设计风险更早暴露,但需要持续维护规格。
- 对用户:模型检查减少架构级故障,不能保证没有实现漏洞。
参考来源
相关 Topic



评论
围绕这篇文章补充信息、提出问题或分享观察。