SequenceHash处理输入边界,安全哈希也会被错误拼接拖累
据 Trail of Bits 公告,团队推出 SequenceHash 与 SequenceMAC 规范及初始实现,用于对多个输入进行无歧义的哈希和消息认证。
作者:韩启明|OC 政策与安全编辑
据 Trail of Bits 公告,团队推出 SequenceHash 与 SequenceMAC 规范及初始实现,用于对多个输入进行无歧义的哈希和消息认证。
一句话结论:哈希算法足够强,不代表应用对输入的编码已经安全。
把两个值直接拼接后哈希,容易丢失边界。例如输入分别为 ab 与 c,或 a 与 bc,拼接结果都是 abc。得到相同摘要不是发现了 SHA-256 的密码学碰撞,而是应用先把不同含义编码成了同一串数据。
多次调用哈希更新接口也不会自动保留字段边界。接口通常只是继续输入字节,最终仍像直接连接一样处理。字段允许为空、长度可变或顺序改变时,协议设计更需要明确表示这些区别。
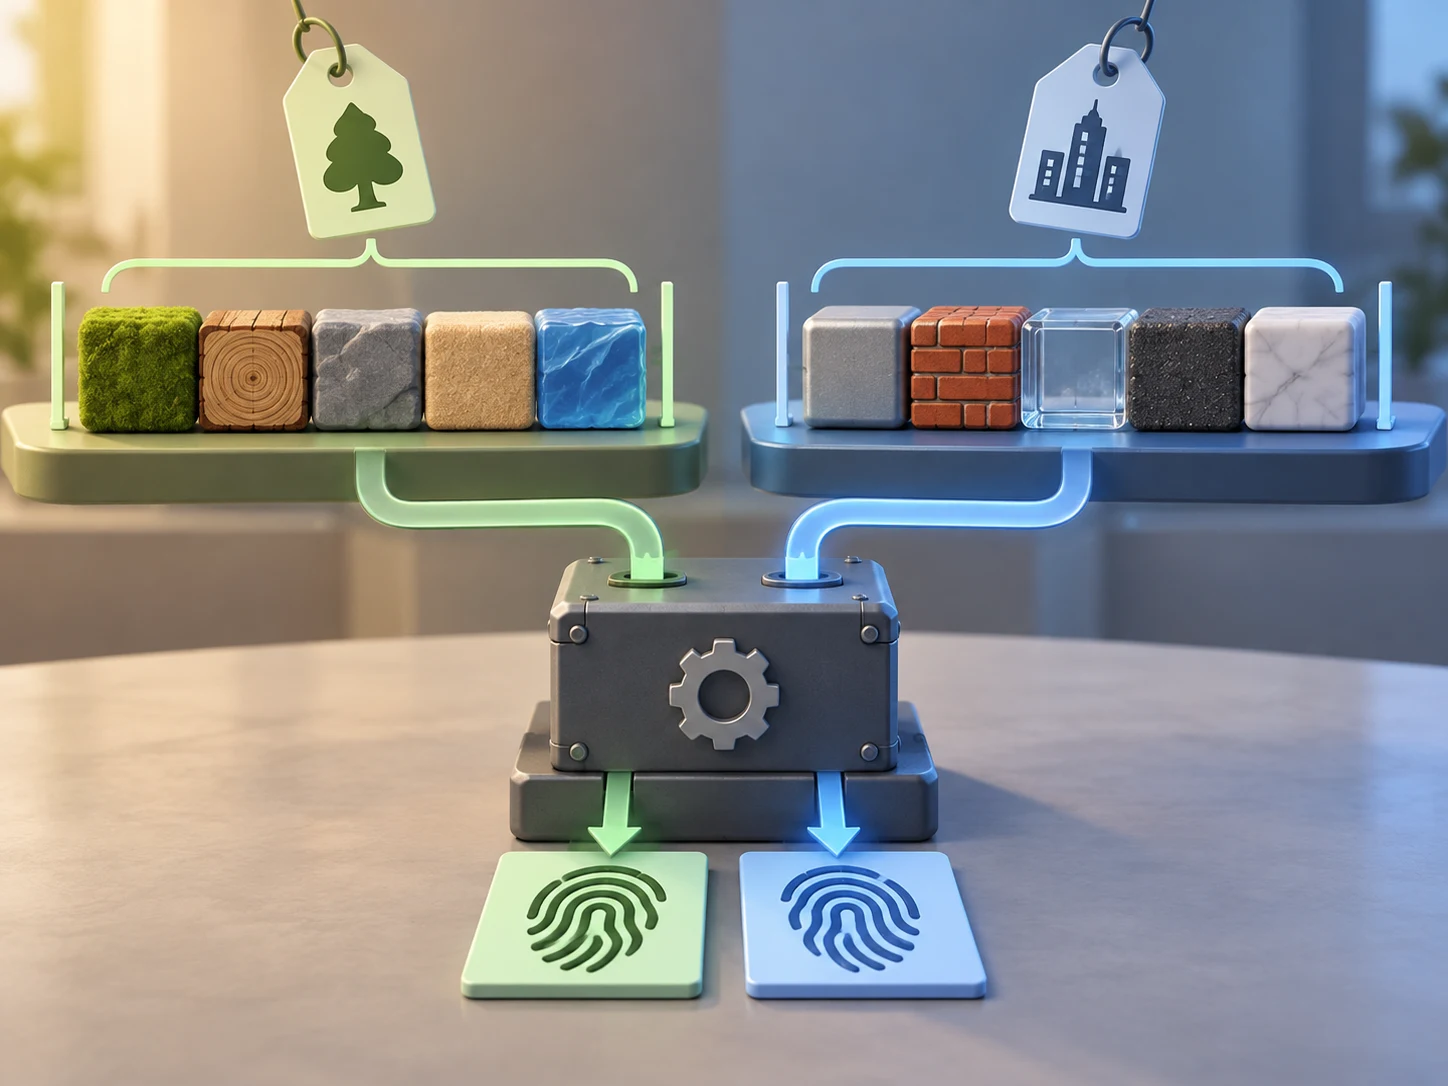
SequenceHash 通过明确编码与双层哈希构造处理此类问题,也提供上下文区分;SequenceMAC 加入密钥用于认证。它们依赖所选底层哈希的安全性,不能把不安全算法变成安全算法。
项目发布 Rust、Go 和 Python 初始实现与测试向量,规范纳入 C2SP。规范和向量有助于不同语言获得一致结果,但一个协议是否正确,还需检查字段类型、顺序、上下文和密钥管理。
开发者可以先审计现有的签名输入、承诺值和多字段摘要。不要为了采用新工具就擅自改变已部署协议的格式;编码变更会影响验证端互操作,需要版本化和明确的迁移安排。
关键事实
- 构造:SequenceHash 与带密钥的 SequenceMAC。
- 作用:多输入的边界、上下文与相关安全处理。
- 分发:公开规范、三种语言初始实现及测试向量。
OC 判断
密码学接口应帮助开发者表达真实含义。安全评估既要看算法,也要看传入算法之前的数据如何编码。
为什么重要
- 对开发者:审计可变长度字段和空输入。
- 对企业:为协议变更保留版本与互操作测试。
- 对用户:底层算法名称不能独立证明应用安全。
评论
围绕这篇文章补充信息、提出问题或分享观察。