JetBrains拆解代码RAG,先保住语法边界再谈向量压缩
JetBrains 的工程文章 介绍了为 Air 构建语义代码检索的取舍,包括按语法结构切块、评估检索结果以及压缩向量索引。
作者:林岚|OC 开发者生态编辑
JetBrains 的工程文章 介绍了为 Air 构建语义代码检索的取舍,包括按语法结构切块、评估检索结果以及压缩向量索引。
一句话结论:代码检索的质量先取决于片段是否完整、上下文是否够用,向量维度只是其中一环。
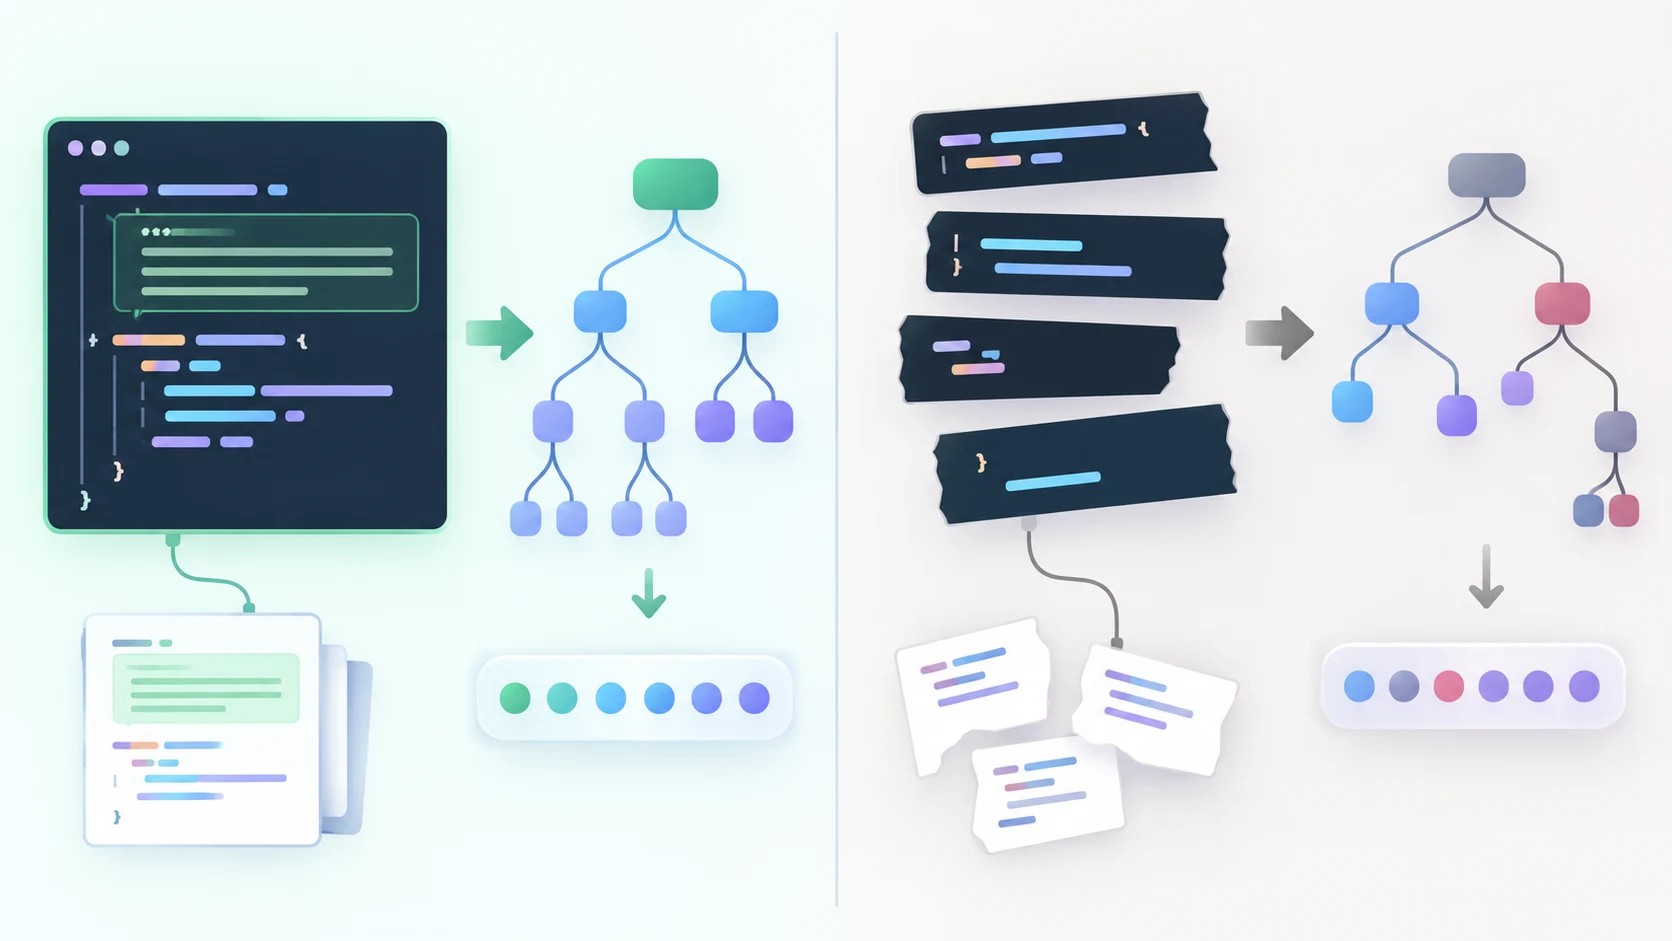
项目采用 AST 结构切块,并尽量让文档、注解与对应声明留在一起。暂不支持结构解析的语言仍需要回退策略。函数名命中但函数说明被切到另一块,这类问题不会因为换成更大的嵌入模型就自动消失。
压缩部分也有明确口径。文章以 4096 维向量为例,把每维 32 位浮点改成 1 位符号表示,原始向量存储可从 16KB 降到 512 字节。这是向量本体的 32 倍差异,不是整个代码索引体积或查询速度都改善 32 倍。
二值向量可以支持相对排序,却会让绝对分数的含义改变。JetBrains 在一些需要判断相关程度是否超过阈值的场景保留更精细的表示。检索第一名和检索结果已经足够相关,是两种不同的判断。
OC 认为,代码助手最容易掩盖的问题正是后一种:总能找到最像的一段,但这段可能不包含调用约束、错误处理或版本差异。系统需要明确告诉后续代理哪些是已检索到的证据,哪些上下文仍缺失,而不是让答案流畅度替代相关性判断。
工程文章公开了切块和索引的权衡,但检索质量依然不等于修改质量。找到正确入口之后,代理还要理解依赖、运行测试并验证行为。团队评估这类能力时,可以记录一次任务是否找到必要定义和调用点,而不只统计搜索结果有没有看起来合理的代码。
关键事实
- 来源:JetBrains 对 Air 代码检索管线的工程说明。
- 切块:优先保留语法结构及相关文档,存在语言覆盖与回退边界。
- 压缩:32 倍指示例中的原始向量存储比例,不能外推整个系统。
OC 判断
这份说明的价值是把 RAG 从模型名和向量库名单还原为工程问题。代码上下文的组织方式、分数的使用方式,往往比单项参数更影响代理能否作出正确修改。
为什么重要
- 对开发者:检索结果应能追溯到完整声明和必要上下文。
- 对企业:评估检索时同时看缺失信息与错误关联,不能只看命中数量。
- 对用户:代码助手引用了仓库内容,也仍然需要可验证的修改结果。

评论
围绕这篇文章补充信息、提出问题或分享观察。