OC
虚假加密会议如何诱导安全研究员安装恶意软件
科技 · 2026-08-21 · 政策与安全 · 阅读 12

虚假加密会议如何诱导安全研究员安装恶意软件

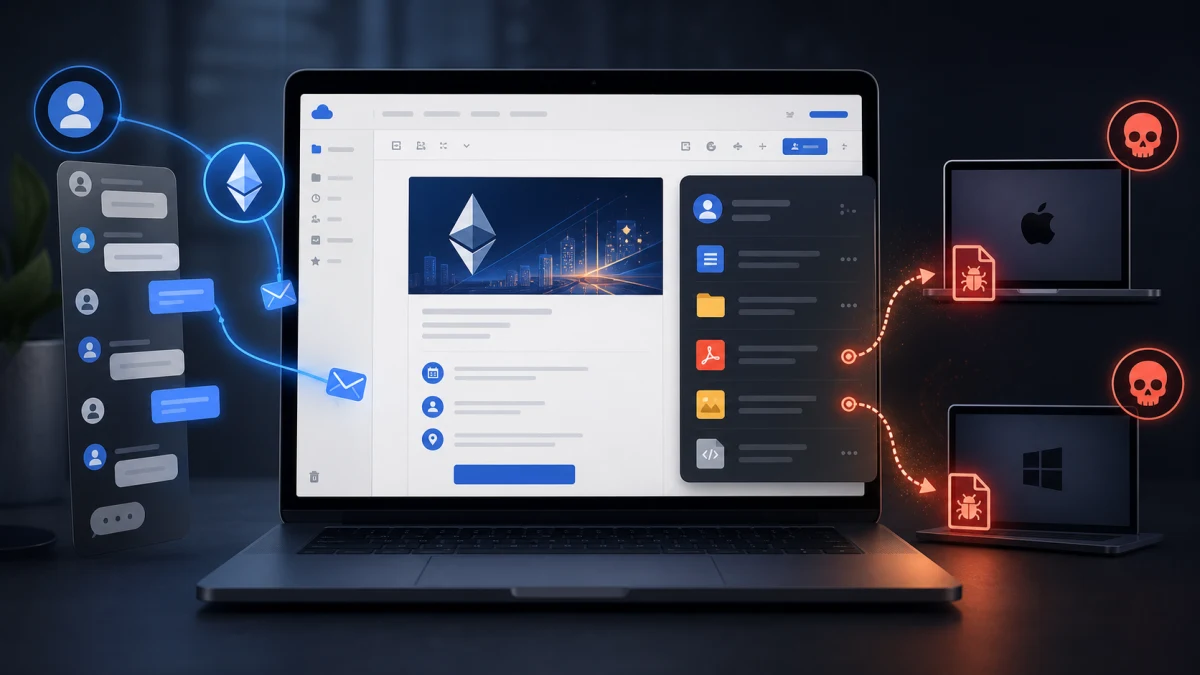
据 TechCrunch 报道,一名攻击者在 Black Hat 和 Def Con 等安全会议前后,通过 X 联系安全研究员,以虚假的加密会议为诱饵,把目标引向一份 Google Docs 文档。

据 TechCrunch 报道,一名攻击者在 Black Hat 和 Def Con 等安全会议前后,通过 X 联系安全研究员,以虚假的加密会议为诱饵,把目标引向一份 Google Docs 文档。

这次攻击并没有伪造一个复杂的官方网站。攻击者反而使用了真实的 Google 文档和 Google Apps Script,在文档侧边栏里制造“加密”“输入解密密钥”等界面。对经常处理安全资料的人来说,可信平台和熟悉工作流会降低戒心,这正是社交工程最有效的地方。

Huntress 研究员在跟进攻击时发现,文档里的“解密”步骤只是后续安装的前置动作。攻击者根据目标系统提供不同载荷:面向 macOS 的信息窃取工具、面向 Windows 的远程桌面工具,以及伪装成 Ledger 钱包的安装程序。它们的共同点不是技术路线相同,而是都把用户的信任转化成了主动安装。

这起事件也说明,云文档的安全边界不能只看文件本身。Google Docs 的脚本和侧边栏功能本来是为了扩展协作能力,但在攻击链里,它们也能被用来制作更像“企业内部工具”的交互。浏览器显示的是 Google 的域名,不代表文档里的脚本、链接和下一步操作都经过 Google 背书。

对研究员和开发团队而言,最危险的动作仍然是把“看到一个界面”当成“完成一次验证”。任何要求输入私密解密口令、下载会议工具、运行脚本或安装钱包的流程,都应该离开原对话,改用官方域名和独立渠道确认。尤其是来自社交平台私信的邀请,不能因为对方知道你的研究方向或会议行程就自动获得可信度。
社交平台私信、云文档和跨平台载荷组成的攻击链

关键事实

  • 目标:安全研究员和安全会议参与者。
  • 入口:X 私信、虚假会议邀请、Google Docs 侧边栏。
  • 载荷:macOS 信息窃取工具、Windows 远程控制工具和伪造钱包安装程序。
  • 证据来源:Huntress 调查和 TechCrunch 对攻击过程的报道。

OC 判断

这类攻击的升级不在于“恶意软件更高级”,而在于攻击者把合法云服务的组件拼成了可信流程。企业安全培训如果只教员工识别假域名,已经覆盖不了这种“真域名承载假意图”的攻击。

为什么重要

  • 对开发者:开发者账号、SSH 密钥、钱包和浏览器凭证往往集中在同一台机器上。
  • 对企业:云文档脚本、浏览器扩展和远程会议工具都应进入软件供应链审查范围。
  • 对普通用户:不要在陌生文档中输入解密口令,也不要仅因为文档来自 Google 就安装后续程序。

参考来源

相关阅读

基于标题、摘要和正文内容自动匹配。

更多科技

评论

围绕这篇文章补充信息、提出问题或分享观察。

0
暂无评论。

发表评论

继续看看 OC 用户围绕这个话题说了什么、做了什么。

相关碎碎念

更多

在我的windows游戏本,也安装了codex,现在叫chatgpt app。然后用遥控的方式操作这个codex去做很多事情,比如以前windows游戏本没空间了,我需要打开steam、gog、战网,然后手工看一堆目录的占用。现在直接用codex做个扫描。然后决定要不要暂时删除某个游戏啥的。 以前要在windows游戏本实验一些必须N卡的AI项目要自己去安装,现在也都交给Codex来做,我就在我习惯的mac环境下遥控即可

tinyfool 0 0

帕格尼物语的任务全部打穿,然后开始玩社区创作的地图,这种游戏在建设的时候特别过瘾,建立起稳定的经济模型后也很过瘾,稳定下来观察小人的行为也很过瘾,然后如果没有外部矛盾,比如敌人侵略或者必须找到某种材料,等等的问题,就开始索然无味了。 人生其实也像这样的游戏,我曾经构建过几次自己的稳定架构,然后就索然无味,然后又因为抑郁,崩塌了,我在人生这个游戏最近感觉有有点动力不足,就是因为每次架构彻底崩塌才来重建,十分疲惫

tinyfool 0 1

最近越来越多思考,我们跟agent的关系,比如我最近用blender mcp很多,基本上我算是会用blender的,但是老记不住很多热键,以前我可以做很复杂的模型,但是要是不是的去查blender的操作热键。现在我完全不参与模型的建模,只让codex帮我生成。 但是我还是在查blender的热键,我现在需要的是numpad .这样聚焦到一个对象的方法,我需要的是numpad /这样的方法来把除了选中的对象,其他都隐藏的热键。 换言之,我现在需要高效的人工视觉复检blender mcp的成果,这是我对自己目前blender能力的需求了。

tinyfool 2 0

相关帖子

更多

一个体会,Codex 这种现代 Agent,每天一个变,几天不用就有新惊喜

<p>当然我说的也包括 Claude Code,新功能日新月异,还有就是 AI 能力提升以后,可以做的东西日新月异。还有各种工作流方法日新月异。</p> <p>更好玩的是,我最近经历过很多次,你跟人介绍现在 Codex 可以做到什么样子,他们都觉得很厉害。但是你现场一演示,他们的震撼就更加完全不同了。所以,这种东西,需要大量的 Workshop 去沟通交流,光看文字很难讲清楚,直播、视频也越来越重要了。</p>

tinyfool 1 89

做 AI 语音产品时,授权、撤回和审计日志应该怎么落地?

<p>最近看到越来越多关于声音授权的讨论。对开发者来说,真正麻烦的往往不是“模型能不能模仿”,而是授权如何进入系统、生成结果如何追溯,以及授权撤回后该怎么办。</p> <p>我们在做 FlowSpeech 时也碰到过类似问题。我的体会是,不要把“用户勾选过同意”当成一个布尔字段,而应该把它做成一组可以审计的业务对象。</p> <h2>1. 把声音资产和授权分开</h2> <p>声音文件只描述技术属性,例如哈希、上传者、存储位置和创建时间。授权记录则至少要包含授权主体、用途范围、地域、有效期、来源证据和当前状态。这样同一份声音用于个人试听、商业广告、公开播客时,可以绑定不同的授权,而不是共用一个模糊的 consent=true。</p> <h2>2. 每次生成都保存授权快照</h2> <p>生成任务不要只引用当前授权 ID。授权内容以后可能变更,如果任务只查最新状态,历史结果就无法解释。更稳妥的做法是在任务创建时保存授权版本、文本哈希、声音版本、模型版本和操作者。生成出的音频再记录 artifact_id,并反向关联任务。</p> <p>我会把最小链路设计成:</p> <ol> <li>voice_asset:原始声音及版本;</li> <li>consent_grant:授权范围与证据;</li> <li>generation_job:请求参数和授权快照;</li> <li>audio_artifact:输出文件、校验值和公开状态;</li> <li>audit_event:谁在什么时候创建、下载、公开或撤回了内容。</li> </ol> <h2>3. 撤回不是简单删除一行</h2> <p>授权撤回后,系统至少要阻止新任务,并把相关公开音频进入下架队列。已经交付给客户的文件是否能删除,要按照合同和产品能力区分,不能在界面上承诺技术上做不到的“全球删除”。更现实的状态机是 active、suspended、revoked、expired,并明确每个状态允许哪些动作。</p> <h2>4. 对外展示也要可验证</h2> <p>除了后台日志,公开音频最好带上来源标记或可查询的生成记录。水印不是万能方案,但“可识别的音频 + 可验证的元数据 + 清晰的举报入口”组合起来,比一句“AI 生成”更有用。</p> <p>我们现在做的 <a href="https://flowspeech.io/zh">FlowSpeech</a> 主要解决上下文感知、情绪和停顿控制。越往产品化走,越觉得声音效果只是前半程,权限边界和可追溯性才决定这类工具能不能长期使用。</p> <p>大家在实际项目里会把授权证据放在业务数据库、对象存储,还是单独的审计系统?如果授权撤回,你们通常怎么处理已经生成并交付的音频?</p>

FlowSpeech 0 1