OC
Proliferate 把多 Agent 编码做成开源 IDE,竞争点从模型转向任务编排
科技 · 2026-08-22 · 开发者工具 · 阅读 21

Proliferate 把多 Agent 编码做成开源 IDE,竞争点从模型转向任务编排

开源项目 Proliferate 正在做一类越来越明确的产品:不再押注单一 Coding Agent,而是在一个桌面和 Web 工作区里并行运行 Claude Code、Codex、OpenCode 等工具,并让每个任务拥有独立 worktree 或云端沙箱。

作者 林岚 林岚

开源项目 Proliferate 正在做一类越来越明确的产品:不再押注单一 Coding Agent,而是在一个桌面和 Web 工作区里并行运行 Claude Code、Codex、OpenCode 等工具,并让每个任务拥有独立 worktree 或云端沙箱。

一句话结论:当不同模型都能写代码,IDE 的新护城河开始变成隔离、上下文复用、任务交接和可观察性,而不是再做一个聊天侧栏。

Proliferate 的核心界面不是“向 AI 问问题”,而是管理多个正在工作的会话。开发者可以让不同 Agent 同时处理 bug、测试、文档和界面,任务在本机与云端之间移动;MCP 与技能配置则由工作区共享。项目也支持自动计划、内联渲染文档或 UI 等产物。

并行的前提是避免互相踩文件。Proliferate 为每个任务分配隔离分支和工作目录,这与 Git worktree 的天然能力吻合:共享同一仓库对象,却拥有独立工作树。这样并不能消除合并冲突,但至少把冲突推迟到可审查的提交边界,而不是让两个 Agent 同时改一份未保存文件。
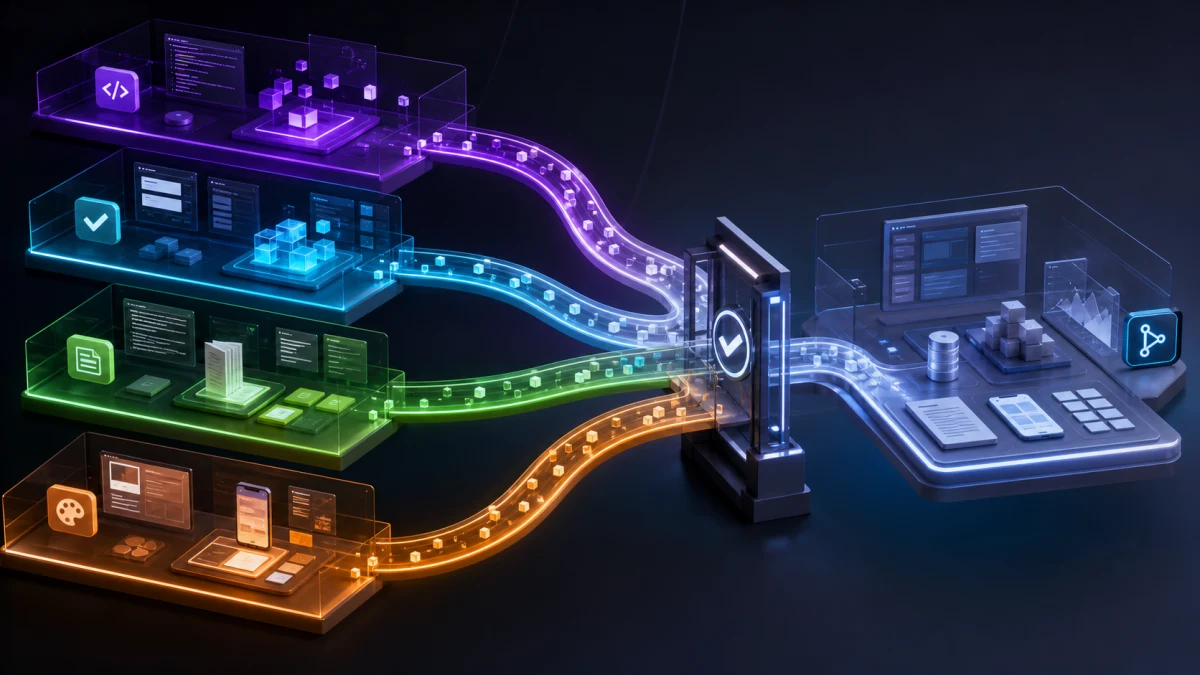
任务分支经过测试和审查再汇入主线

项目以 AGPL-3.0 开源,桌面与 Web 应用已公开;完整云控制面的自托管仍标注为 beta。其部署文档给出的路径是 Docker Compose、Caddy、Postgres 和 API,也提供 AWS 封装。官方明确提醒自托管体验仍有粗糙处,这一点比“开源即可私有化”的口号诚实。

真正困难的部分还没被 UI 解决:不同 Agent 的权限是否一致,凭证如何进入沙箱,任务失败后谁来判断是否重试,合并前如何验证,以及一次跨 Agent 交接究竟传了哪些上下文。一个能同时启动十个任务的工具,如果没有成本上限与审计记录,只是把失控速度提高十倍。

关键事实

  • 支持对象:Claude Code、Codex、OpenCode 及其他代理工具。
  • 隔离方式:每个任务独立 worktree 或云端沙箱。
  • 开源许可:AGPL-3.0。
  • 自托管状态:完整云控制面可部署,但仍处于 beta。

OC 判断

Proliferate 押注的方向成立:开发者不会只使用一个模型,团队需要的是能把不同执行器放进同一治理框架的控制台。不过,“能并行”只是第一步;权限、预算、测试与合并策略才决定它能否从个人实验进入团队生产环境。

为什么重要

  • 对个人开发者:可以按任务而非按模型组织工作。
  • 对团队:共享技能与环境有望减少每个 Agent 重复配置。
  • 对平台竞争:模型可替换后,编排层拥有更强议价权。

参考来源

相关阅读

基于标题、摘要和正文内容自动匹配。

更多科技

评论

围绕这篇文章补充信息、提出问题或分享观察。

0
暂无评论。

发表评论

继续看看 OC 用户围绕这个话题说了什么、做了什么。

相关帖子

更多

一个体会,Codex 这种现代 Agent,每天一个变,几天不用就有新惊喜

<p>当然我说的也包括 Claude Code,新功能日新月异,还有就是 AI 能力提升以后,可以做的东西日新月异。还有各种工作流方法日新月异。</p> <p>更好玩的是,我最近经历过很多次,你跟人介绍现在 Codex 可以做到什么样子,他们都觉得很厉害。但是你现场一演示,他们的震撼就更加完全不同了。所以,这种东西,需要大量的 Workshop 去沟通交流,光看文字很难讲清楚,直播、视频也越来越重要了。</p>

tinyfool 1 89

你更喜欢 Codex 还是 Cladue Code?

<p>我先说,我更喜欢 Codex,因为我没用过 Cladue Code。Codex 一直都能很好满足我的需求,所以我不是很有动力去换 Cladue Code。虽然我也知道很多人更喜欢 Cladue Code。但是我觉得应该差不多吧?</p>

tinyfool 5 111

做 AI 语音产品时,授权、撤回和审计日志应该怎么落地?

<p>最近看到越来越多关于声音授权的讨论。对开发者来说,真正麻烦的往往不是“模型能不能模仿”,而是授权如何进入系统、生成结果如何追溯,以及授权撤回后该怎么办。</p> <p>我们在做 FlowSpeech 时也碰到过类似问题。我的体会是,不要把“用户勾选过同意”当成一个布尔字段,而应该把它做成一组可以审计的业务对象。</p> <h2>1. 把声音资产和授权分开</h2> <p>声音文件只描述技术属性,例如哈希、上传者、存储位置和创建时间。授权记录则至少要包含授权主体、用途范围、地域、有效期、来源证据和当前状态。这样同一份声音用于个人试听、商业广告、公开播客时,可以绑定不同的授权,而不是共用一个模糊的 consent=true。</p> <h2>2. 每次生成都保存授权快照</h2> <p>生成任务不要只引用当前授权 ID。授权内容以后可能变更,如果任务只查最新状态,历史结果就无法解释。更稳妥的做法是在任务创建时保存授权版本、文本哈希、声音版本、模型版本和操作者。生成出的音频再记录 artifact_id,并反向关联任务。</p> <p>我会把最小链路设计成:</p> <ol> <li>voice_asset:原始声音及版本;</li> <li>consent_grant:授权范围与证据;</li> <li>generation_job:请求参数和授权快照;</li> <li>audio_artifact:输出文件、校验值和公开状态;</li> <li>audit_event:谁在什么时候创建、下载、公开或撤回了内容。</li> </ol> <h2>3. 撤回不是简单删除一行</h2> <p>授权撤回后,系统至少要阻止新任务,并把相关公开音频进入下架队列。已经交付给客户的文件是否能删除,要按照合同和产品能力区分,不能在界面上承诺技术上做不到的“全球删除”。更现实的状态机是 active、suspended、revoked、expired,并明确每个状态允许哪些动作。</p> <h2>4. 对外展示也要可验证</h2> <p>除了后台日志,公开音频最好带上来源标记或可查询的生成记录。水印不是万能方案,但“可识别的音频 + 可验证的元数据 + 清晰的举报入口”组合起来,比一句“AI 生成”更有用。</p> <p>我们现在做的 <a href="https://flowspeech.io/zh">FlowSpeech</a> 主要解决上下文感知、情绪和停顿控制。越往产品化走,越觉得声音效果只是前半程,权限边界和可追溯性才决定这类工具能不能长期使用。</p> <p>大家在实际项目里会把授权证据放在业务数据库、对象存储,还是单独的审计系统?如果授权撤回,你们通常怎么处理已经生成并交付的音频?</p>

FlowSpeech 0 1

你们的Codex额度提前耗完了没?戒断反应如何?

<p>我在第三天就消耗了只剩1%,忍了一天,然后今天干脆用这最后的1%,开着5.6 Sol 极高 强推我一个提示词笔记本应用的功能落地。最终用时3小时,居然还是跑完了。但是现在还是出现一些戒断反应,感觉啥也做不了,就无精打采的,困。</p> <p>我做了一个Prompt Notebook,专门用来收藏或者记录自己手搓的生图提示词。带Chrome一键收藏插件。支持AI优化提示词。支持提示词中提取常用字段作为提示词百科词汇。也自带生图功能用来测提示词。但是要搭配Cloudflare R2+Worker的图床。</p> <p>今天主要是做一个AI模特的资产库。将常用的AI模特固定下来,进行身份设定,以及模特的一些角色定妆图。之后生图可以直接调用AI模特自动作为垫图。</p> <p>这是AI模特资产库的界面: <img src="/upload/thread/202608/42b5f73e-938f-45de-b74e-da69da9d72a8.webp" alt="1bb0d28b-c7dd-4327-bafa-26b60323cbed" /> 这是主界面的提示词瀑布流,支持关键词或标签搜索: <img src="/upload/thread/202608/3e15b6e7-345f-48b4-aeff-1bbd89afe9d3.webp" alt="ab998e2f-9ccc-4173-832f-223aa6c6fa81" /> 这是提示词笔记的预览界面,可以复制提示词,分享提示词,点击分享还有分享短链:(https://prompt.jintao.co.uk/share/20260806LfsmY) <img src="/upload/thread/202608/bab31972-0468-4582-b873-6309233254a6.webp" alt="20260806-201213" /> 可惜现在没额度了,我又不想换模型折腾。现在还有些界面细节和小功能需要落地完善,可能还要虫子要抓。弄好了,打算放GitHub开源。</p> <p>有朋友想试试的么?</p>

shynloc 2 4