OC
日本邮政 CSV 为什么这么难解析:地址不是字符串,而是一套例外制度
科技 · 2026-08-30 · 工程实践 · 阅读 4

日本邮政 CSV 为什么这么难解析:地址不是字符串,而是一套例外制度

开发者为日本邮政编码数据制作 Python 库 posuto 时,发现官方 CSV 远不是“邮编、县、市、町名”四列这么简单。长字段会跨行拆分,括号里混有范围说明,部分地区使用“以下除外”式兜底记录,甚至同一个词在绝大多数行是注释,在某一个真实地址里却必须保留。

作者:林岚|OC 开发者生态编辑

开发者为日本邮政编码数据制作 Python 库 posuto 时,发现官方 CSV 远不是“邮编、县、市、町名”四列这么简单。长字段会跨行拆分,括号里混有范围说明,部分地区使用“以下除外”式兜底记录,甚至同一个词在绝大多数行是注释,在某一个真实地址里却必须保留。

一句话结论:地址数据不是一张可以靠 split(',') 解决的表,而是行政历史、投递规则、旧软件限制和自然语言例外共同形成的制度接口。

原始文件为了兼容字段长度限制,会把超过阈值的地名或读音拆成多条记录。解析器不能把每一行当独立地址,而要识别哪些行是前一条的延续,再恢复完整町域。京都的部分地址还会使用路口和方向描述,天然比常见层级式地址长,更容易触发拆分。

括号不是统一的可删除备注。有的括号列举适用番地,有的表示“除此之外”,有的内容需要转成排除规则。CSV 中的“一円”通常表示“周边全部区域”,适合作为说明移除;但滋贺县恰好存在一个町名本身就是“一円”,邮编 522-0317。写一条全局替换规则,就会把真实地名删掉。
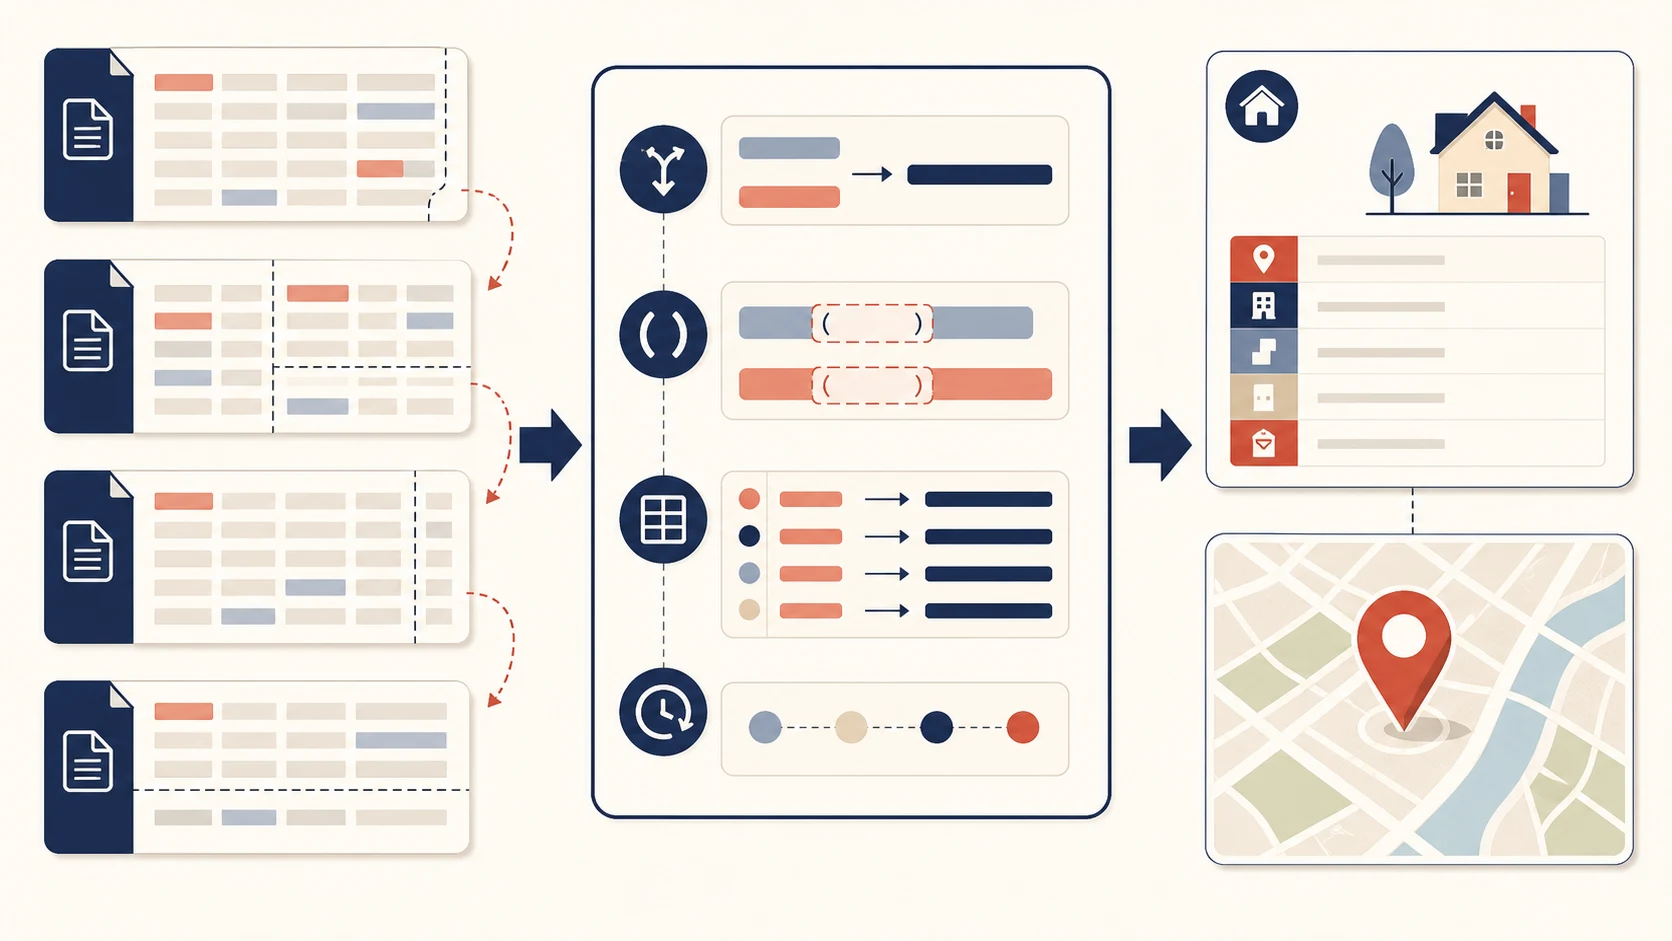
地址清洗需要结构化规则、例外表和回归样本

罗马字文件又是另一套问题。日本邮政提供的版本更新较慢,可能与主文件不同步,而且转换质量不稳定。原文举例,已经是拉丁字母的“JA”被先按日语读音处理,再错误拆解小假名,最后变成难以辨认的字母串;“Roppongi Hills”也会被机械转写。作者因此建议,在需要罗马字时考虑独立工具 cutlet,而不是把官方字段当绝对真值。

posuto 的做法是把复杂清洗封装成库,同时提供预处理 JSON,方便非 Python 项目使用。它的价值不只是“修好一个 CSV”,而是把隐含规则变成代码和测试。不过,任何第三方清洗层都要跟随官方更新,记录原始版本,并允许用户追溯某条地址怎样被合并或改写。

这类问题对国际化产品很常见。姓名、电话、地址和行政区划看似是字符串,实际都包含地域规则。工程上最危险的做法,是先按自己熟悉的国家设计 schema,再把其他地区当异常值塞进去。例外不是脏数据;很多时候,它就是业务本身。

关键事实

  • 来源:posuto 作者对日本邮政 CSV 的解析复盘
  • 数据难点:超长字段跨行、括号范围、兜底区域、历史地址表达
  • 特殊案例:“一円”通常是说明,但在一处也是实际町名
  • 输出方式:Python 库与预处理 JSON

OC 判断

解析器最难的部分从来不是逗号,而是语义。官方提供文件不等于文件适合直接进入现代应用;第三方库也不能靠几条正则永久解决。可靠方案需要版本化原始数据、显式例外、可追溯转换和真实地址回归样本。

为什么重要

  • 对开发者:不要把物理行等同于业务记录,也不要无条件删除括号和注释词。
  • 对产品团队:日本地址搜索、物流和表单体验取决于本地规则,而非简单翻译。
  • 对数据团队:官方数据仍需质量评估、版本管理和转换可追溯性。

参考来源

相关阅读

基于标题、摘要和正文内容自动匹配。

更多科技

评论

围绕这篇文章补充信息、提出问题或分享观察。

0
暂无评论。

发表评论

继续看看 OC 用户围绕这个话题说了什么、做了什么。

相关碎碎念

更多

OC有3万多注册用户,但是这些人哪些活跃,哪些不活跃?哪些发过帖子,哪些没有,其实以前都很麻烦去计算。这两天想了下,在后台,加入了注册用户细分的界面,然后一下子一目了然了。图片是测试服务器的测试数据,跟真实OC的数据不同步,但是大概可以看一个感觉了。

tinyfool 0 0

最近越来越多思考,我们跟agent的关系,比如我最近用blender mcp很多,基本上我算是会用blender的,但是老记不住很多热键,以前我可以做很复杂的模型,但是要是不是的去查blender的操作热键。现在我完全不参与模型的建模,只让codex帮我生成。 但是我还是在查blender的热键,我现在需要的是numpad .这样聚焦到一个对象的方法,我需要的是numpad /这样的方法来把除了选中的对象,其他都隐藏的热键。 换言之,我现在需要高效的人工视觉复检blender mcp的成果,这是我对自己目前blender能力的需求了。

tinyfool 2 0

在我的windows游戏本,也安装了codex,现在叫chatgpt app。然后用遥控的方式操作这个codex去做很多事情,比如以前windows游戏本没空间了,我需要打开steam、gog、战网,然后手工看一堆目录的占用。现在直接用codex做个扫描。然后决定要不要暂时删除某个游戏啥的。 以前要在windows游戏本实验一些必须N卡的AI项目要自己去安装,现在也都交给Codex来做,我就在我习惯的mac环境下遥控即可

tinyfool 0 0

相关帖子

更多

奉劝大家不要移民了

<p>对于大多数人而言,移民就是悲剧。实在看不下去了,大家不要往火坑里面跳。 国内发展那么快,你出国去慢车道,消费又高,又存不下钱,又要拼命适应当地环境,何苦? 老老实实在大城市找工作,根据收入买房子上车就好。</p> <p>补充:大城市觉得房价太高太辛苦,就好好学好英语,美国远程回老家省会城市,拿同比一线的收入,三线城市的开销,岂不美哉?</p> <p>转文章: <a href="https://mp.weixin.qq.com/s?__biz=MzAxNTMxMTc0MA==&amp;mid=2651016481&amp;idx=1&amp;sn=6bde227438ea02e3da3673295821692e&amp;chksm=80721b32b705922448a9f8645e8d1a8450e57151b71e58beb64e0addf9485ad0b256a431d68b&amp;mpshare=1&amp;scene=1&amp;srcid=0530QgwbtdDlMP4ZG7Nkonpo&amp;pass_ticket=bz%2FdHaz2YWQrgwhgQlVVXt866SMnyXU53Dd0OzDmMc1uZeu0PqND%2FjdQ6fQk8Bdl#rd"> 中产阶级的地雷阵 #D03 </a></p> <p>更多文章:<a href="https://mp.weixin.qq.com/s?__biz=MzAxNTMxMTc0MA==&amp;mid=503532389&amp;idx=1&amp;sn=84ff5eefb88e1b17f9ec0efb0238140d&amp;chksm=00721d76370594601903172e49477ce0ed149a3ba1bdcb88a300b55c8c552a79ea31134216ae&amp;mpshare=1&amp;scene=1&amp;srcid=0719VQx1dNX5rlraUqjWtCFm&amp;pass_ticket=bz%2FdHaz2YWQrgwhgQlVVXt866SMnyXU53Dd0OzDmMc1uZeu0PqND%2FjdQ6fQk8Bdl#rd">列表</a></p>

halida 198 9

做 AI 语音产品时,授权、撤回和审计日志应该怎么落地?

<p>最近看到越来越多关于声音授权的讨论。对开发者来说,真正麻烦的往往不是“模型能不能模仿”,而是授权如何进入系统、生成结果如何追溯,以及授权撤回后该怎么办。</p> <p>我们在做 FlowSpeech 时也碰到过类似问题。我的体会是,不要把“用户勾选过同意”当成一个布尔字段,而应该把它做成一组可以审计的业务对象。</p> <h2>1. 把声音资产和授权分开</h2> <p>声音文件只描述技术属性,例如哈希、上传者、存储位置和创建时间。授权记录则至少要包含授权主体、用途范围、地域、有效期、来源证据和当前状态。这样同一份声音用于个人试听、商业广告、公开播客时,可以绑定不同的授权,而不是共用一个模糊的 consent=true。</p> <h2>2. 每次生成都保存授权快照</h2> <p>生成任务不要只引用当前授权 ID。授权内容以后可能变更,如果任务只查最新状态,历史结果就无法解释。更稳妥的做法是在任务创建时保存授权版本、文本哈希、声音版本、模型版本和操作者。生成出的音频再记录 artifact_id,并反向关联任务。</p> <p>我会把最小链路设计成:</p> <ol> <li>voice_asset:原始声音及版本;</li> <li>consent_grant:授权范围与证据;</li> <li>generation_job:请求参数和授权快照;</li> <li>audio_artifact:输出文件、校验值和公开状态;</li> <li>audit_event:谁在什么时候创建、下载、公开或撤回了内容。</li> </ol> <h2>3. 撤回不是简单删除一行</h2> <p>授权撤回后,系统至少要阻止新任务,并把相关公开音频进入下架队列。已经交付给客户的文件是否能删除,要按照合同和产品能力区分,不能在界面上承诺技术上做不到的“全球删除”。更现实的状态机是 active、suspended、revoked、expired,并明确每个状态允许哪些动作。</p> <h2>4. 对外展示也要可验证</h2> <p>除了后台日志,公开音频最好带上来源标记或可查询的生成记录。水印不是万能方案,但“可识别的音频 + 可验证的元数据 + 清晰的举报入口”组合起来,比一句“AI 生成”更有用。</p> <p>我们现在做的 <a href="https://flowspeech.io/zh">FlowSpeech</a> 主要解决上下文感知、情绪和停顿控制。越往产品化走,越觉得声音效果只是前半程,权限边界和可追溯性才决定这类工具能不能长期使用。</p> <p>大家在实际项目里会把授权证据放在业务数据库、对象存储,还是单独的审计系统?如果授权撤回,你们通常怎么处理已经生成并交付的音频?</p>

FlowSpeech 0 1

一个体会,Codex 这种现代 Agent,每天一个变,几天不用就有新惊喜

<p>当然我说的也包括 Claude Code,新功能日新月异,还有就是 AI 能力提升以后,可以做的东西日新月异。还有各种工作流方法日新月异。</p> <p>更好玩的是,我最近经历过很多次,你跟人介绍现在 Codex 可以做到什么样子,他们都觉得很厉害。但是你现场一演示,他们的震撼就更加完全不同了。所以,这种东西,需要大量的 Workshop 去沟通交流,光看文字很难讲清楚,直播、视频也越来越重要了。</p>

tinyfool 1 89

你为什么不移民?

<p>我是一定要移了,在这里连正常呼吸都不行了。以前正常呼吸指的是言论自由,现在是生物学意义的正常呼吸问题了。</p> <p>你为什么不移民?</p>

tinyfool 741 48