Hister 搜索你看过的网页,私人索引也有数据边界
据 Hister 项目仓库,这个个人搜索工具可以索引用户浏览过的网页和文件,并提供 Web、终端及 MCP 等使用入口。它解决的不是“互联网上有什么”,而是“我明明看过的那一页在哪里”。
作者:周白|OC 产品体验编辑
据 Hister 项目仓库,这个个人搜索工具可以索引用户浏览过的网页和文件,并提供 Web、终端及 MCP 等使用入口。它解决的不是“互联网上有什么”,而是“我明明看过的那一页在哪里”。
一句话结论:把自己的阅读历史变成全文索引很实用,但索引留下了什么、谁能访问、是否调用外部服务,都应由用户明确掌握。
很多找不到的资料,其实不是没读过,而是想不起标题。浏览器历史里一长串网址帮不上忙,收藏夹又只收了当时主动保存的内容。个人全文搜索的价值,就是允许用户凭一段记忆中的措辞,把那页资料找回来。
Hister 通过浏览器扩展等方式收集并索引内容,可以在本机或自有基础设施运行。项目强调默认没有遥测与云同步,也说明了站点图标获取等网络行为。这里的“私人”不是一个可以盖住所有数据路径的词:具体边界仍取决于部署和配置。
找回页面,意味着多留了一份内容
全文搜索之所以比网址列表更有用,是因为它留住的不只是链接。于是,用户应把索引当成一份真实的数据副本,而不是一个无关紧要的缓存。
假设访问过某个内部文档,后来原站点删除了内容或收回权限,之前建立的索引是否还保留文本?这需要根据工具的删除与同步机制确认,不能自动假设源页面消失,所有副本也同步消失。这里讨论的是个人索引的一般使用边界,不是声称 Hister 已发生泄露。
尤其在共享电脑、备份盘或自托管服务器上,谁能访问索引与谁能访问浏览器,并不一定是同一批人。部署便利不能代替访问控制。
语义搜索的便利,可能跨出本机
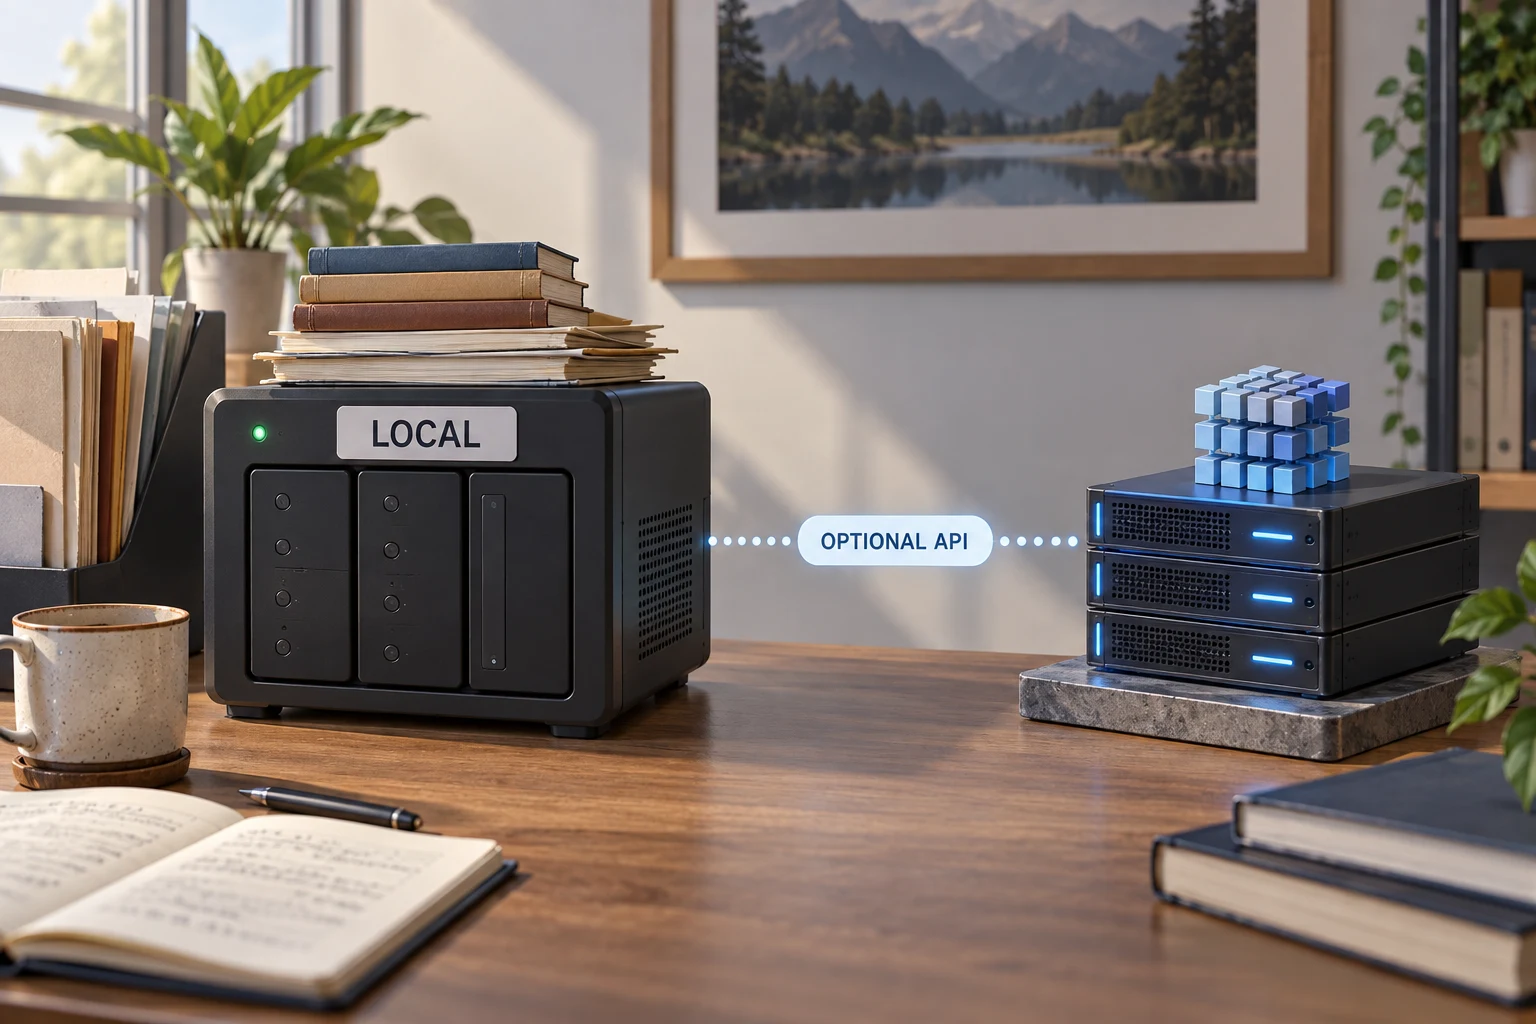
项目还提供可选的语义检索能力,通过配置的嵌入接口生成向量。若这个接口是外部服务,相关文本就可能离开本地环境。因此,“默认不云同步”和“所有配置都不向外发送内容”是两句话。
这并不意味着语义检索一定不该开。它能帮助用户在想不起原词时找到相关材料,但需要知道使用的是本地模型还是远程接口,以及服务端如何处理数据。输入普通公开文章,与输入客户材料,应该有不同的评估标准。
接到 Agent 后,搜索结果仍只是资料
MCP 入口让个人档案可以被 AI 助手使用,进一步减少复制粘贴。相应地,使用者也应考虑助手能取到多少内容、结果会被送到哪里,以及是否需要按任务限制检索范围。
网页里可能包含各种文字,包括诱导模型执行动作的指令式内容。搜索命中的文章不因此获得控制助手的权限。把外部资料当数据、把真正授权留在用户与运行环境中,是接入这类工具时应坚持的边界。
好的私人搜索,也应该容易清理
从产品体验看,排除某些站点、查看已保存内容和删除记录,与搜索速度同样重要。用户不应等到发现敏感资料被索引后,才去研究数据库文件藏在哪里。
Hister 的吸引力在于把资料管理权交回使用者,但自主运行同时带来维护责任。它更像一个可以按需配置的个人资料层,而不是装上以后便无需关心的数据保险箱。
关键事实
- 用途:检索访问过的网页与文件,而非替代公共搜索引擎。
- 入口:浏览器扩展、Web、终端及 MCP 等。
- 默认承诺:项目称没有遥测和云同步,不等于任何配置都不联网。
- 可选功能:语义检索使用所配置的嵌入服务,外部接口会改变数据边界。
OC 判断
OC 喜欢这类范围清楚的工具:不急着替用户思考,先把已经读过的东西找回来。但“个人”应落实为能看见、能排除、能删除、能限制访问。只有搜索没有清理机制,资料库越有用,维护负担也可能越大。
为什么重要
- 对重度阅读者:可以减少反复搜索同一篇资料的时间。
- 对开发者:接入个人知识层时,要同时设计取数范围和外部服务边界。
- 对组织用户:自托管不自动满足内部资料政策,索引与备份也属于数据资产。


评论
围绕这篇文章补充信息、提出问题或分享观察。