Java 27 正式发布,默认行为比九项新特性更值得先检查
据 OpenJDK 发布邮件,Java 27 的参考实现 JDK 27 已进入正式可用阶段,GA 采用 build 35。九项 JEP 中既有默认行为调整,也有仍处于预览或孵化阶段的功能,不能把它们统一理解成“正式稳定的新 API”。
作者:林岚|OC 开发者生态编辑
据 OpenJDK 发布邮件,Java 27 的参考实现 JDK 27 已进入正式可用阶段,GA 采用 build 35。九项 JEP 中既有默认行为调整,也有仍处于预览或孵化阶段的功能,不能把它们统一理解成“正式稳定的新 API”。
一句话结论:升级评估应先检查默认行为和生产观测,再决定是否启用预览能力。
GA 不意味着每一项特性都结束试验
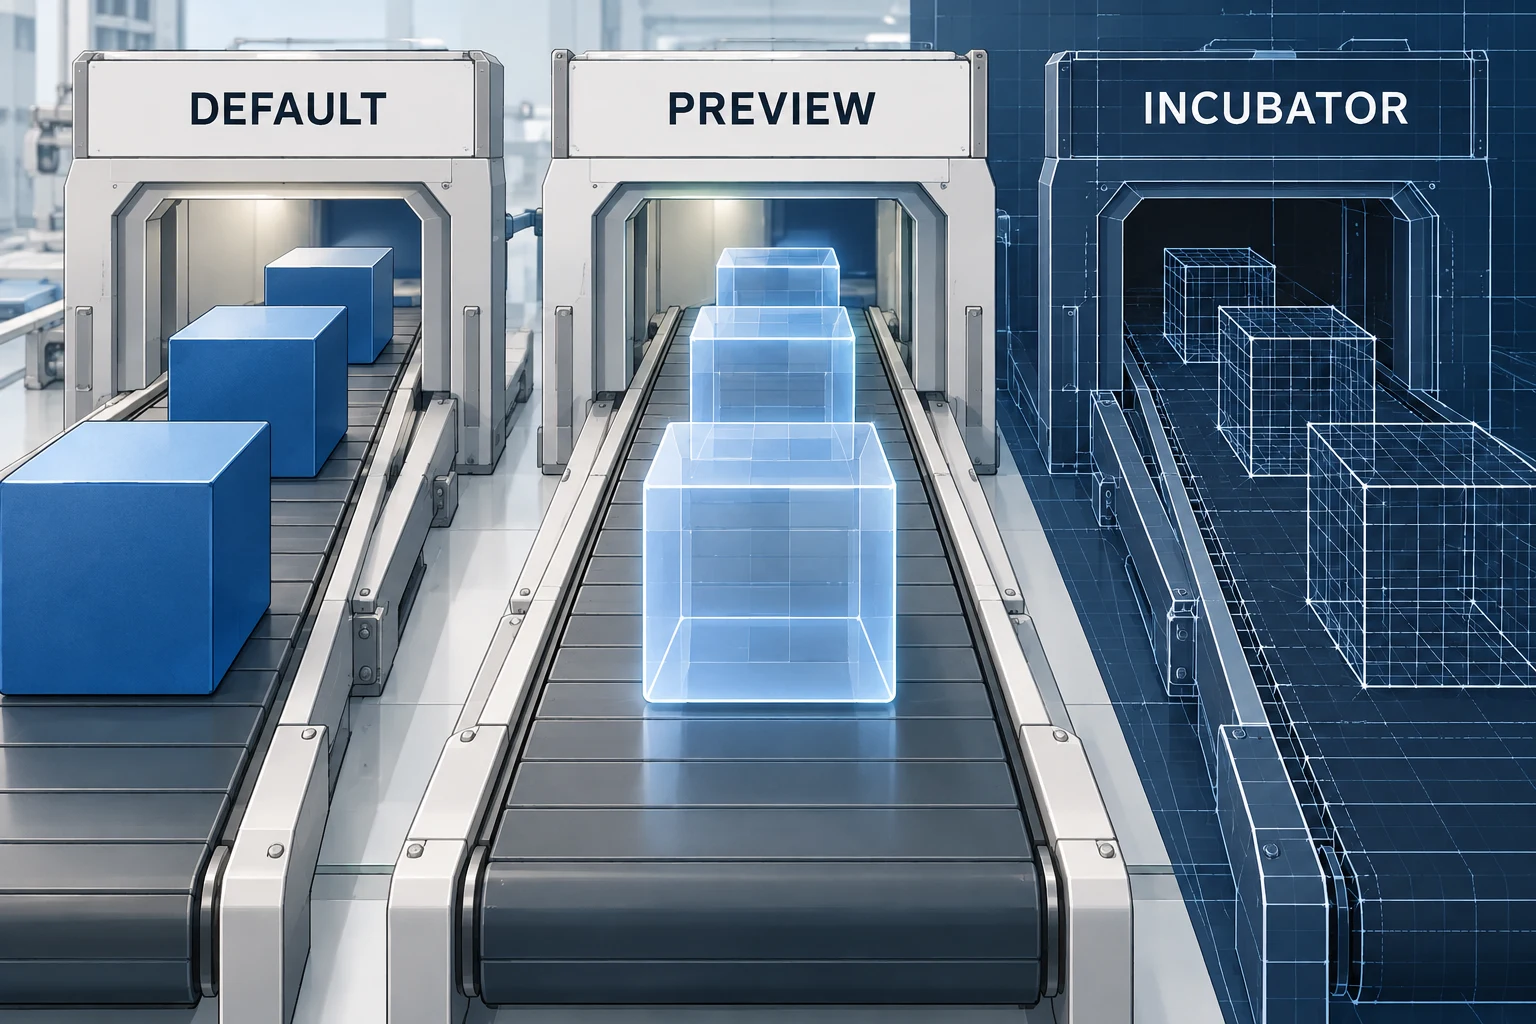
一个 JDK 可以正式发布,同时携带预览功能。两件事并不矛盾:平台发行版具有明确的交付状态,而某些语言或库接口还在收集反馈、继续演进。
Java 27 的清单中,结构化并发、惰性常量等仍带有 Preview 标记,Vector API 则仍属于 Incubator。团队如果把这些接口纳入长期公共契约,就需要额外考虑后续版本变化。
因此,评审升级计划时应把“换运行时”和“采用新接口”拆开。前者可能主要涉及兼容性与性能回归,后者还会改变代码的维护承诺。
默认值变化会碰到没有主动改过代码的团队
G1 在所有环境中成为默认垃圾收集器,以及紧凑对象头成为默认,是这一版值得先排查的变化。默认值之所以重要,恰恰因为用户可能什么参数都没改,运行方式却发生了变化。
对象布局和回收行为影响的是不同层面:前者关系到大量小对象占用的空间,后者关系到内存回收的时机和代价。不能把它们简单合并成“更省内存,因此一定更快”。
实际结果还取决于对象形态、堆大小、分配频率和服务负载。团队需要用自己的流量观察,而不是把默认开启当作无条件收益。
先保住可比较性,再看性能数字
一次升级如果同时更换 JDK、容器镜像、启动参数和依赖版本,发现延迟变化后往往很难定位原因。对照环境至少应记录这些差异,并保留可以回退的旧配置。
关注平均响应时间还不够。长尾暂停、启动速度、峰值内存和故障期间的行为,都可能影响最终采用决定。批处理任务与低延迟服务,也未必对同一项变化作出相同评价。
正式可用说明发行版已经完成相应发布流程,不代表替每一个业务完成了生产验收。
诊断数据也有信息边界
JFR 进程内数据脱敏进入本次特性清单,提醒开发者注意另一类成本:为了排查故障而采集的记录,也可能包含不适合广泛分发的信息。
观测工具越方便,越需要明确谁能开启、谁能读取以及记录保留多久。脱敏能力可以成为控制点,但不能被理解为所有诊断文件自动没有敏感内容。
尤其当多个团队共享性能记录时,数据字段和脱敏配置应当与分析目标一并确认。安全处理与有用的排障信息,需要通过具体规则取得平衡。
安全协议更新也要走完整条链
Java 27 还纳入 TLS 1.3 后量子混合密钥交换支持。对部署者而言,支持某种协议能力,与每一次连接都实际协商使用它,是不同问题。
服务端、客户端、中间设备和运行配置共同决定最终连接行为。迁移测试除了检查“能连上”,也应观察兼容性与失败回退,避免把版本号当成整条链路的证明。
Java 的优势之一是成熟的升级节奏,而成熟恰恰意味着不必为展示新特性把所有变化一次用完。先理解默认项,再按需要扩大采用范围,通常更接近生产系统的真实节奏。
关键事实
GA 为 build 35;本版包含九项 JEP;默认项、Preview 与 Incubator 并存;正式发行不等于所有新 API 均已定型。
OC 判断
版本更新的第一张检查表应该写运行环境与默认参数,而不是只列语法亮点。
为什么重要
默认值会影响没有修改源码的应用;明确特性状态,则能避免把试验接口无意间变成长期兼容性负担。


评论
围绕这篇文章补充信息、提出问题或分享观察。