联合国数据接入 Agent,权威数字不会自动变成权威结论
据 Google 9 月 17 日公告,联合国系统推出 UN System Data Commons,以统一知识图谱连接分散的统计资料,并支持自然语言检索和通过 MCP 接入 AI 助手。
作者:林岚|OC 开发者生态编辑
据 Google 9 月 17 日公告,联合国系统推出 UN System Data Commons,以统一知识图谱连接分散的统计资料,并支持自然语言检索和通过 MCP 接入 AI 助手。
一句话结论:让 Agent 找到正式统计数据,是重要的基础设施进展;让它正确解释数据,仍是另一项工作。
过去查一组跨国指标,常常不是输几个关键词就能结束。人口数据在一个库,教育数据在另一个库,年份和地区名称还可能对不上。新的入口试图缩短这段搜集、匹配和整理时间,而不是再训练一个把所有数字背下来的聊天模型。
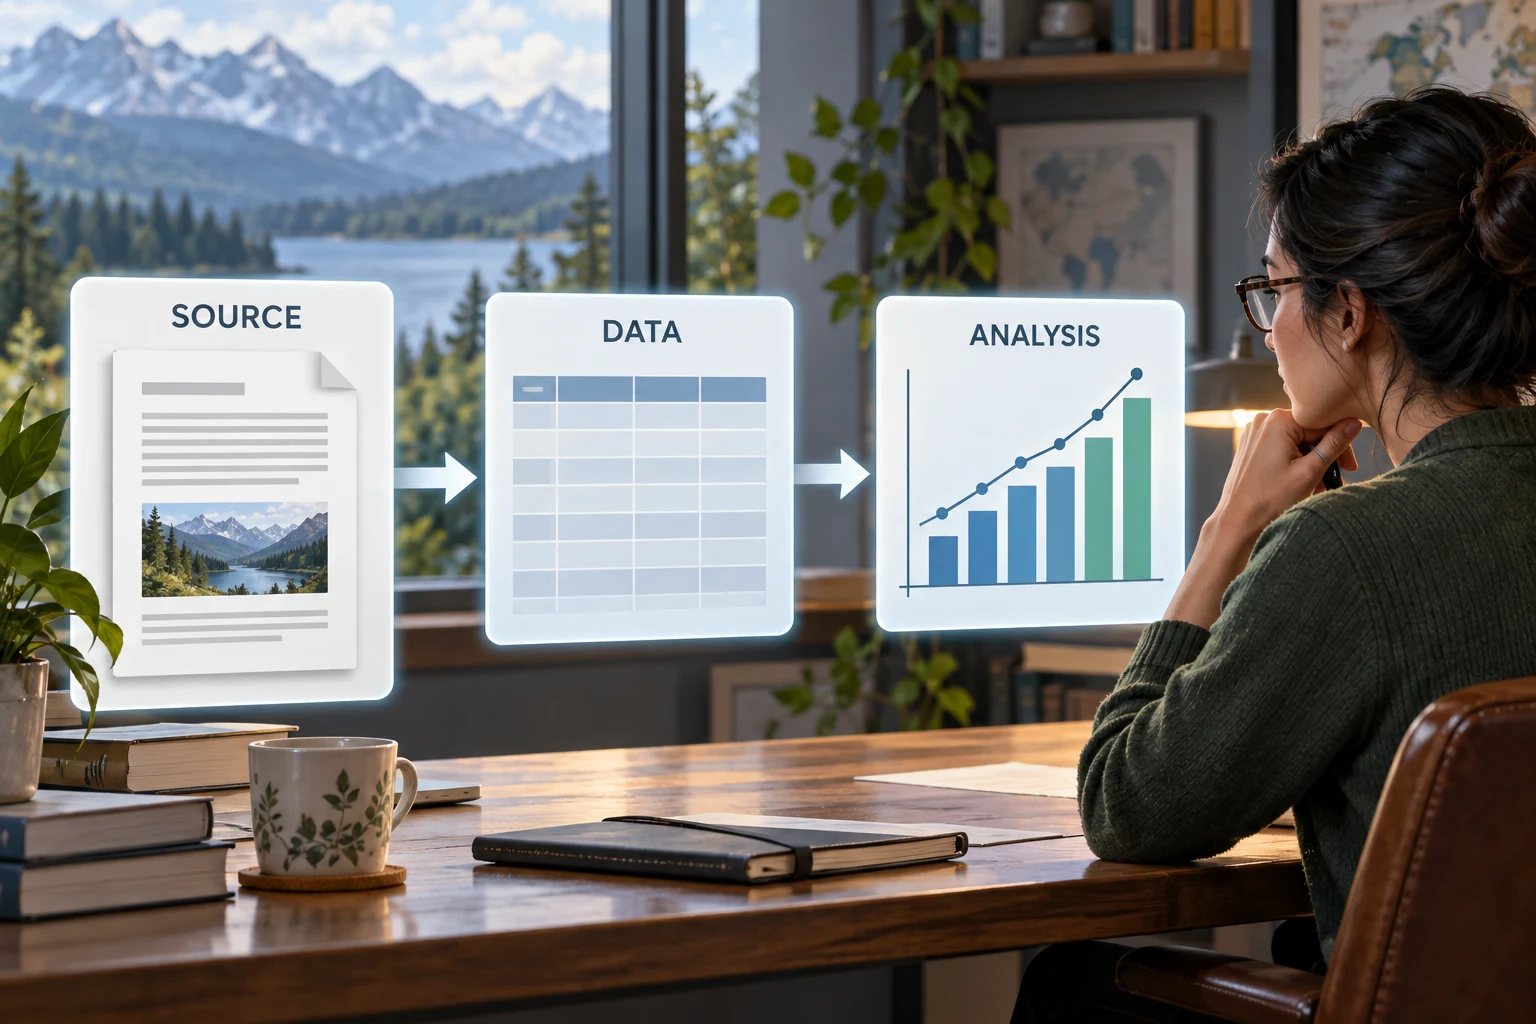
Google 的说明提到,平台将指标、时间与地理信息连接起来,数据经过联合国统计及技术人员校验;AI 助手可以取数并生成图表或报告草稿。公告同时提醒,引用重要数字前仍需检查底层来源。它还把“到 2027 年覆盖联合国系统 80% 的统计数据集”列为目标,不能把这个比例写成当前覆盖率。
数字有出处,比较仍然可能出错
假设有人问:“哪些地方的供水改善最能带动入学率提高?”系统检索到两个真实指标,只完成了第一步。供水指标记录的是全国还是农村?入学率对应哪个年龄段?两个序列是否同年?这些选择都会改变图表的含义。这是解释数据的通用问题,并不表示新平台已经出现了这些错误。
进一步说,两个指标同时上升,也不能单凭一张图就认定存在因果关系。收入变化、人口迁移和政策投入都可能影响结果。权威机构对数据来源负责,并不意味着它为模型临时写出的每个推论背书。
最有价值的输出,是能回头检查
对开发者而言,这类接入适合做一个可核对的资料助手:回答里留下指标名称、单位、年份、地区和原始出处,而不仅是一个漂亮的数字。数据没有覆盖的年份应明确留空,不该由语言模型悄悄补齐;把缺失当成零,会直接改变趋势。
同样重要的是保留查询条件。用户今天问“贫困率”,下周复用同一份报告,若指标定义或来源版本发生变化,两次结果不一定能直接拼接。能重跑、能比较版本,比一次回答看起来很流畅更有长期价值。
平台宣传的“AI ready”容易让人误以为机器已经理解了资料的全部语境。更准确的理解是,数据有了更适合机器访问和关联的组织方式。访问协议解决“怎么拿”,统计判断处理“拿来的东西能说明什么”,两者不能互相替代。
关键事实
- 发布方:联合国系统;底层采用 Google Data Commons 开源技术。
- 新入口:自然语言探索及面向 AI 助手的 MCP 接入。
- 覆盖目标:2027 年达到联合国系统统计数据集的 80%,不是当前完成率。
- 使用边界:关键数字仍需回查来源,模型解释不是联合国结论。
OC 判断
这项变化的价值不在于让 AI 更像一个无所不知的专家,而是给它一条可追溯的取数路径。OC 更看重回答能否暴露口径和缺口:一份明确标出“年份不齐,不能直接比较”的结果,往往比强行画出完整排名更可靠。
为什么重要
- 对开发者:可以减少数据接入的重复劳动,把精力放在来源与口径展示上。
- 对机构:缩短整理资料的时间,但不宜撤掉研究和审核环节。
- 对读者:判断报告时不仅看出处是否权威,也要看推论是否超过数据支持的范围。


评论
围绕这篇文章补充信息、提出问题或分享观察。