TIN 把全文搜索搬进 Postgres,关键在少做一次地址转换
据 PlanetScale 9 月 16 日公告,全文搜索扩展 TIN 已面向其 Postgres 和 Neki 数据库正式可用。它支持关键词组合、短语查询、计数和 BM25 排序。这不是所有 PostgreSQL 安装都自动获得的新内核功能,而是该公司提供的扩展能力。
作者:林岚|OC 开发者生态编辑
据 PlanetScale 9 月 16 日公告,全文搜索扩展 TIN 已面向其 Postgres 和 Neki 数据库正式可用。它支持关键词组合、短语查询、计数和 BM25 排序。这不是所有 PostgreSQL 安装都自动获得的新内核功能,而是该公司提供的扩展能力。
一句话结论:TIN 值得关注的不是一个脱离条件的倍数,而是让搜索索引更贴近 Postgres 的存储和事务机制。
搜索为什么还要再查一遍地址
设想一个商品库:搜索先找出描述包含关键词的商品,再过滤库存、商家和权限,最后返回前十项。如果搜索系统在数据库外面,开发者还要维护两份数据如何同步;如果搬进数据库,索引又必须适应数据库自己的行版本和执行器。
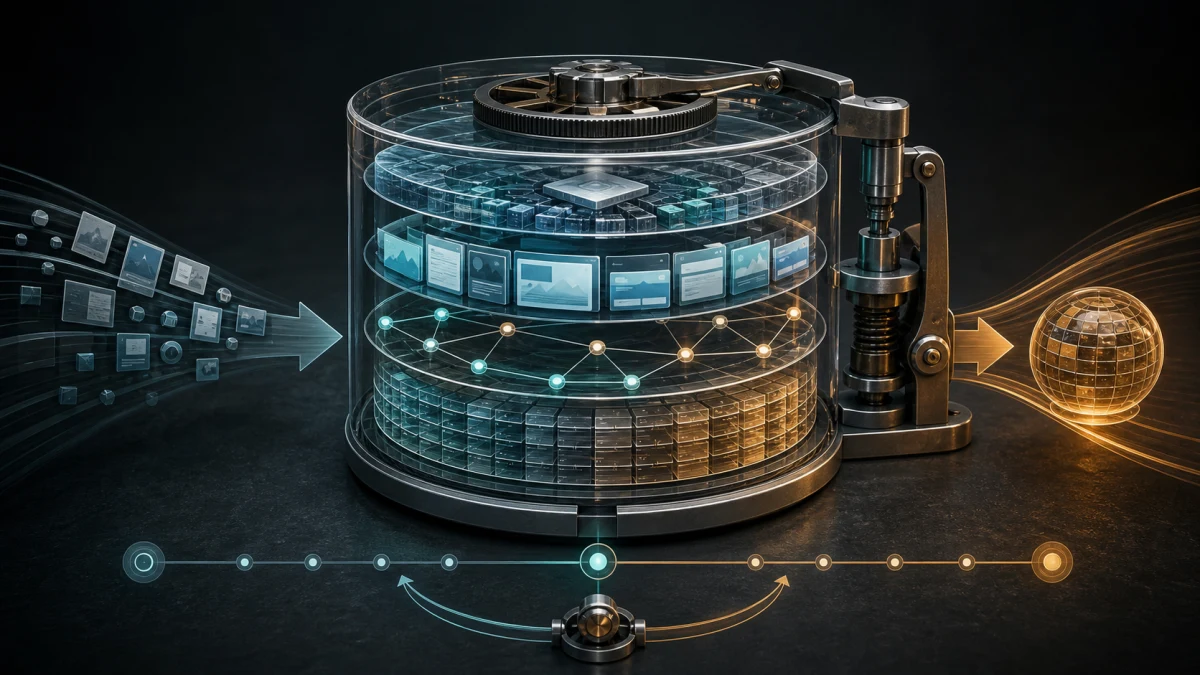
TIN 的核心选择是直接用 ctid 表示索引命中的行版本,而不是先创建另一套文档编号、再把编号翻译回数据库地址。对命中量很大的检索,少一层映射意味着少一批查找,而不只是少几行应用代码。其两级位图把页和页内位置分别组织,便于批量求交、求并;这是厂商对性能来源的解释,不是 OC 的实测结论。
这里有个容易被照搬错的细节:PostgreSQL 文档明确提醒,更新以及某些物理移动会改变 ctid。它适合定位物理行版本,不适合当业务主键。扩展内部利用这个地址,与应用把它永久存进订单表,是两回事。
基准里真正值得看的条件
公告中的一个混合查询、只读、前十项排序测试,报告 TIN 为 199 QPS,对比 ParadeDB 的 7.9 QPS。测试使用 85GB 语料、合成查询、每个查询容器 8 vCPU 和 32GB 内存,并采用支持 AVX-512 的机器。数字来自 PlanetScale,不能直接换算成你的网站会快多少倍。
尤其不能把几种任务混在一起:计数不需要返回完整文档;排前十名不等于完整列出全部命中;只读表现也不能替代持续更新时的延迟。先问结果语义是否一致,再看速度,才有比较意义。
少一个服务,并没有少掉一致性
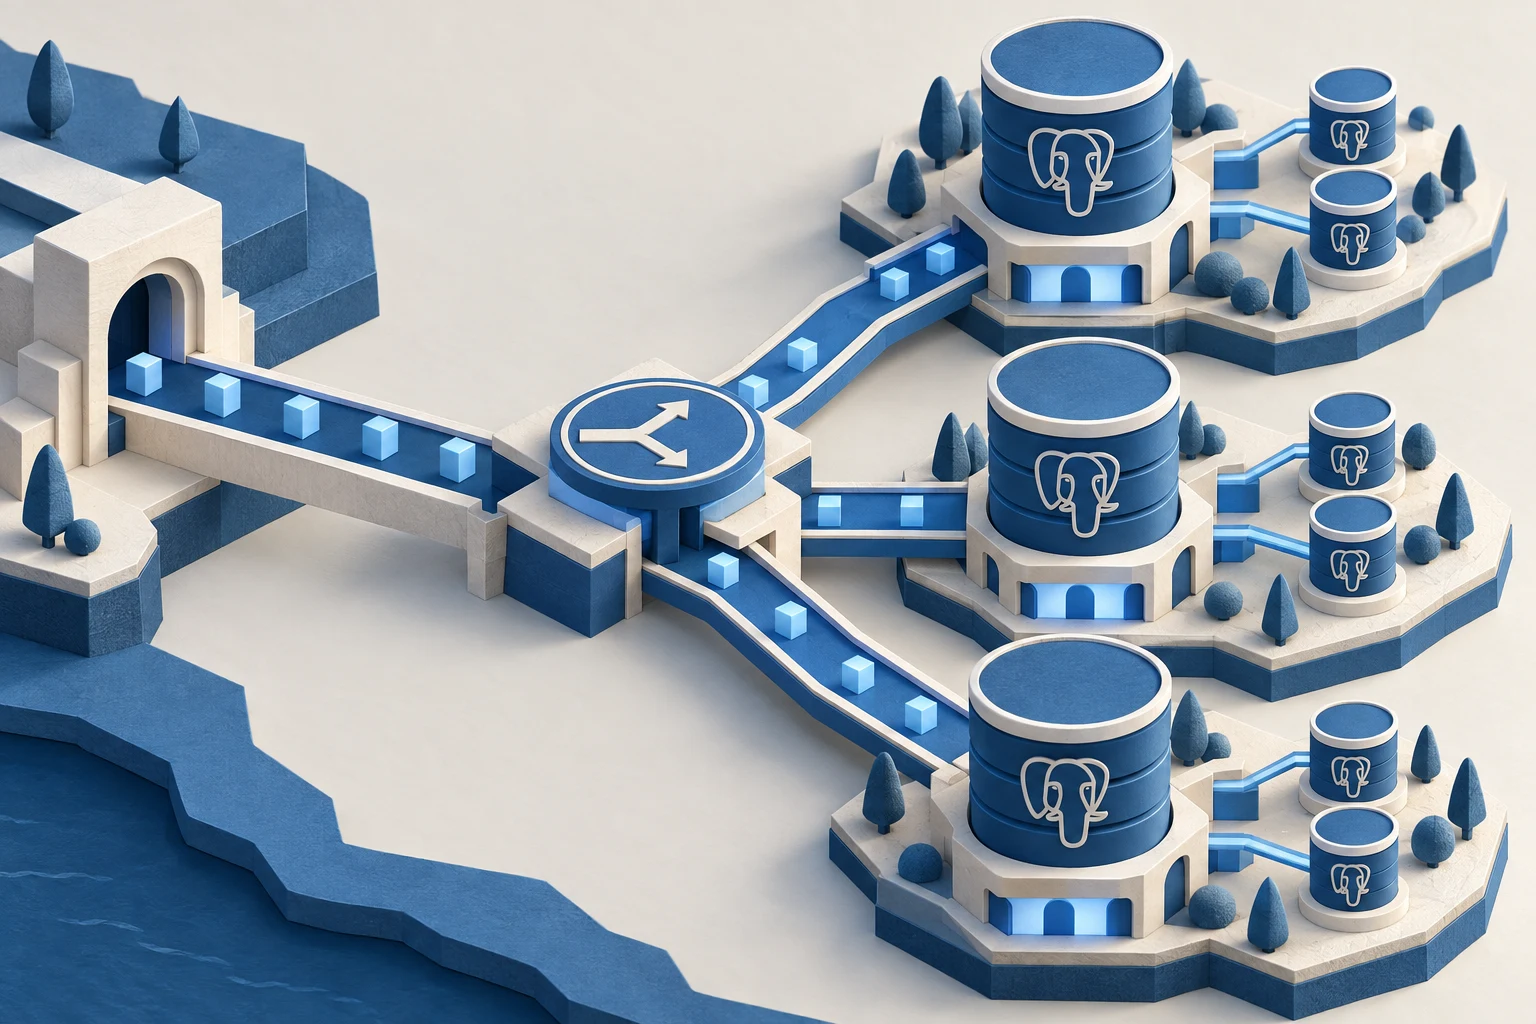
在数据库里搜索的实际吸引力,是筛选条件和事务可以放进同一条查询。比如商品刚下架,业务不希望数据库说不存在、搜索页却继续推荐。可见性、删除清理和后台合并因此都是搜索功能的一部分,而不是上线后的附加题。
TIN 说明其实现会配合事务可见性检查及 VACUUM 清理失效版本。对采用者来说,更实际的验证是构造自己的更新、删除、回滚和并发查询,观察它们是否仍返回预期结果,而不是只导入静态文本跑一次。
评估中文站点,还应单独查看分词、专名、错别字、繁简混用和相关性。支持关键词搜索不自动意味着满足站内搜索体验。一个能极快返回错误排序的索引,省下的等待时间可能会花在用户反复改词上。
将搜索放回主库也会改变资源竞争:索引创建、维护和查询与交易负载共享预算。减少独立搜索集群的运维,可能换来更仔细的主库容量规划。这笔账应同时计入,而不是把“架构更简单”理解成“所有成本都消失”。
关键事实
- 发布:9 月 16 日;本批为补充报道,并非 9 月 19 日当天发布。
- 范围:PlanetScale 的 Postgres / Neki 产品。
- 证据:功能和性能来自厂商公告,OC 未独立复现。
- 注意:物理行地址不是稳定业务标识。
OC 判断
林岚认为,这类扩展真正有价值的地方,是把原本由业务团队维护的一致性工作下沉到数据库。但采购判断应落在查询正确性、自己的数据分布及维护开销上,不能由最大的性能倍数代替。
为什么重要
- 对开发者:有机会减少搜索同步链路,但仍要验证语言处理和相关性。
- 对企业:比较总维护成本,而不只是单次检索速度。
- 对用户:搜索结果是否及时反映商品、权限和内容变化,比底层叫什么更重要。
评论
围绕这篇文章补充信息、提出问题或分享观察。