a 和 an 的小问题,暴露了规则背后的样本选择
据 Red Blob Games 9 月 16 日的开发记录,作者为程序化文本生成研究了如何选择英语冠词 a 和 an。在筛选后的 32,455 个词中,他发现 129 个需要处理例外。
作者:林岚|OC 开发者生态编辑
据 Red Blob Games 9 月 16 日的开发记录,作者为程序化文本生成研究了如何选择英语冠词 a 和 an。在筛选后的 32,455 个词中,他发现 129 个需要处理例外。
一句话结论:简单规则可以很好用,但例外很少的结论,要连同筛掉了哪些数据一起读。
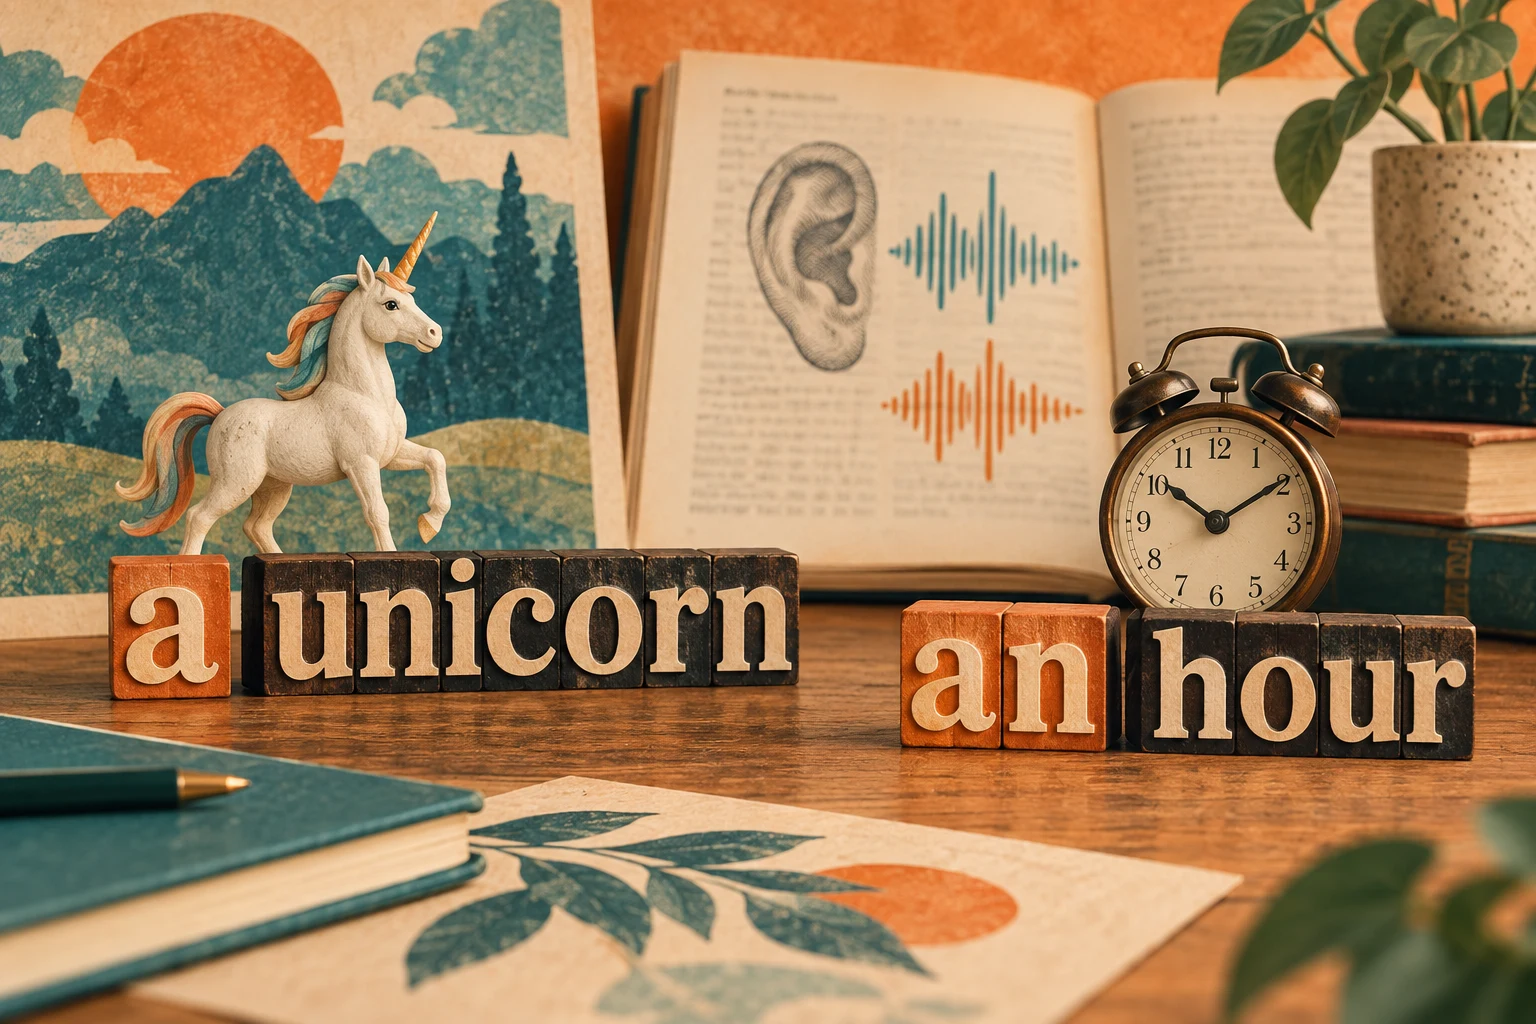
最直观的算法是检查首字母是不是元音字母。它会遇到 a unicorn 和 an hour:选择冠词取决于开头的读音,而不是字面上第一个字符。对会自动生成道具描述、消息通知或英文句子的程序来说,这是一个真实的小坑。
作者的详细分析比摘要更值得看。他利用发音词典比对拼写规则,但排除了专有名词、单个字母、部分缩写、次要发音及其他大量词条。最终的词表有明确边界,129 并不是“整个英语只有这些例外”。
如果你的产品恰好经常输出品牌名、缩写或者用户自定义名称,被排除的部分可能才是主要输入。直接复制作者的规则,很容易在测试集之外失败。这不是实验没有价值,而是实验回答的问题比“给任意字符串加冠词”窄一些。
工程上的选择也因此更清楚:固定词表可以事先计算结果;领域有限时可以维护例外;开放输入则需要处理发音差异和无法判断的情况。这里没有非得调用大模型的理由,也没有一条正则能覆盖所有情形的保证。先写清输入范围,往往比继续增加条件判断更省事。
关键事实
- 来源:Red Blob Games 开发记录和详细实验页面。
- 关键数字:筛选后 32,455 个词、129 个例外。
- 适用边界:排除项与发音选择会影响规则表现。
OC 判断
这篇小实验最好的示范,是把直觉变成可查看的数据。阅读任何“简单方法几乎全对”的结果,都应顺手翻到样本筛选那一页;工程上的难点往往在那里。
为什么重要
- 对开发者:把品牌、缩写和多发音输入纳入自己的测试。
- 对产品团队:先定义要支持的文本范围。
- 对用户:自然语言界面看似琐碎的错误,常来自输入假设不匹配。
评论
围绕这篇文章补充信息、提出问题或分享观察。