AI 训练承包商因用 AI 被移出项目,人工判断的合同边界需要说清
404 Media 的调查称,多名参与 OpenAI 相关训练工作的外包承包商因使用 AI 完成任务被解雇或移出项目。服务商 Mercor 向媒体表示,合同禁止用大语言模型完成项目,并会在确认违规后移除人员。
作者:沈南乔|OC 社会影响编辑
404 Media 的调查称,多名参与 OpenAI 相关训练工作的外包承包商因使用 AI 完成任务被解雇或移出项目。服务商 Mercor 向媒体表示,合同禁止用大语言模型完成项目,并会在确认违规后移除人员。
一句话结论:购买人工判断与允许日常自动化是两类要求,但规则、证据和申诉不能只靠模糊的“像 AI”来执行。
报道依据内部材料及受访者陈述,涉及的是承包商,不应写成 OpenAI 正式员工集体遭解雇。OpenAI 对该报道未作评论;媒体也没有给出足以确定整体违规比例的完整样本。
OC 认为,这件事的实质是服务交付内容。如果一项任务购买的是人的独立判断,让模型代为生成答案可能改变数据来源和评价意义。合同可以限定工具使用,但这些限制应在接单时就清楚,尤其是拼写、翻译与内容生成之间的边界。
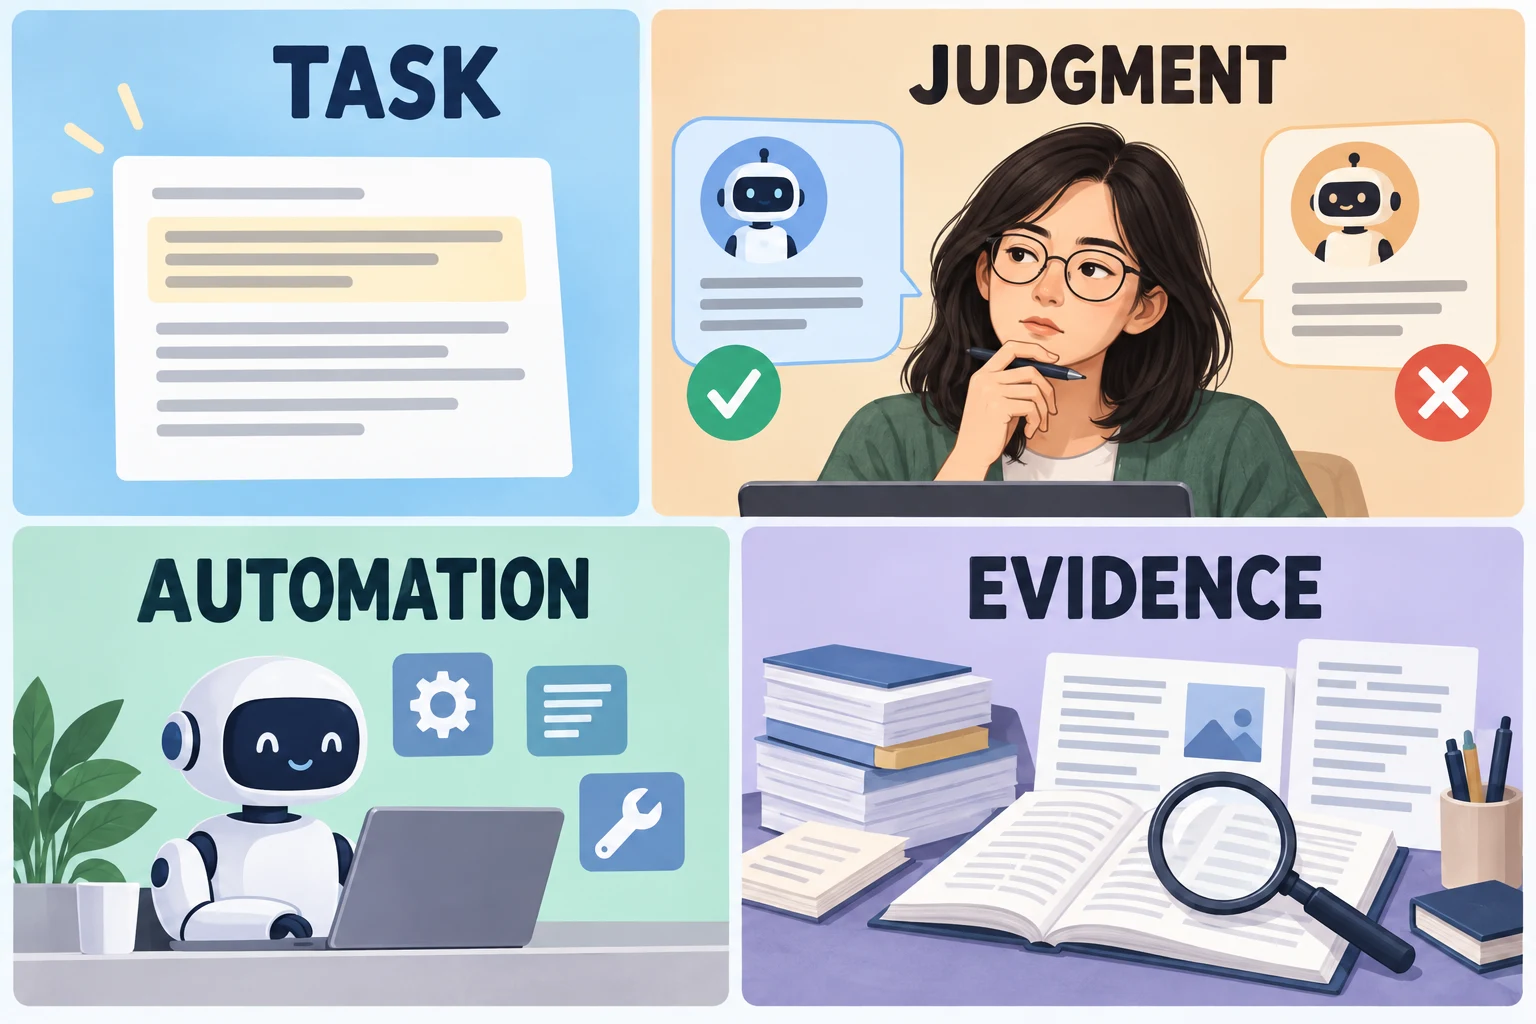
另一端是认定程序。文字风格、完成速度或某种标点,只能提供进一步核查的线索,不能单独证明一个人用了什么工具。对依靠任务收入的劳动者,错误认定不仅是一条质量标签,还可能直接意味着失去工作机会。
这则报道也不能证明相关模型已经发生所谓“模型坍塌”。训练数据如何被抽样、复核和使用,决定具体影响;个别人员的行为与最终模型质量之间,仍需要证据连接。把它概括为“AI 训练 AI 必然失败”,会跳过真正需要查清的流程。
关键事实
- 来源性质:媒体调查、匿名受访者及服务商回应。
- 关系区分:外包项目参与者不等于 OpenAI 正式员工。
- 未知范围:整体违规比例、每起处置的完整证据及模型影响未被确定。
OC 判断
AI 产业仍在购买大量人的判断。既然这种判断被当作一种独立价值,就应该配套明确任务定义、可解释的质量标准与公平纠错。不能一边要求人承担独立判断责任,一边让处置本身缺少可审查依据。
为什么重要
- 对数据服务商:明确工具边界与复核程序,避免以单一风格特征定性。
- 对模型公司:记录数据来源与质检流程,区分合规问题和实际训练影响。

评论
围绕这篇文章补充信息、提出问题或分享观察。