一句“不要猜”把字段幻觉降到两成,结构化抽取仍不能只靠提示词
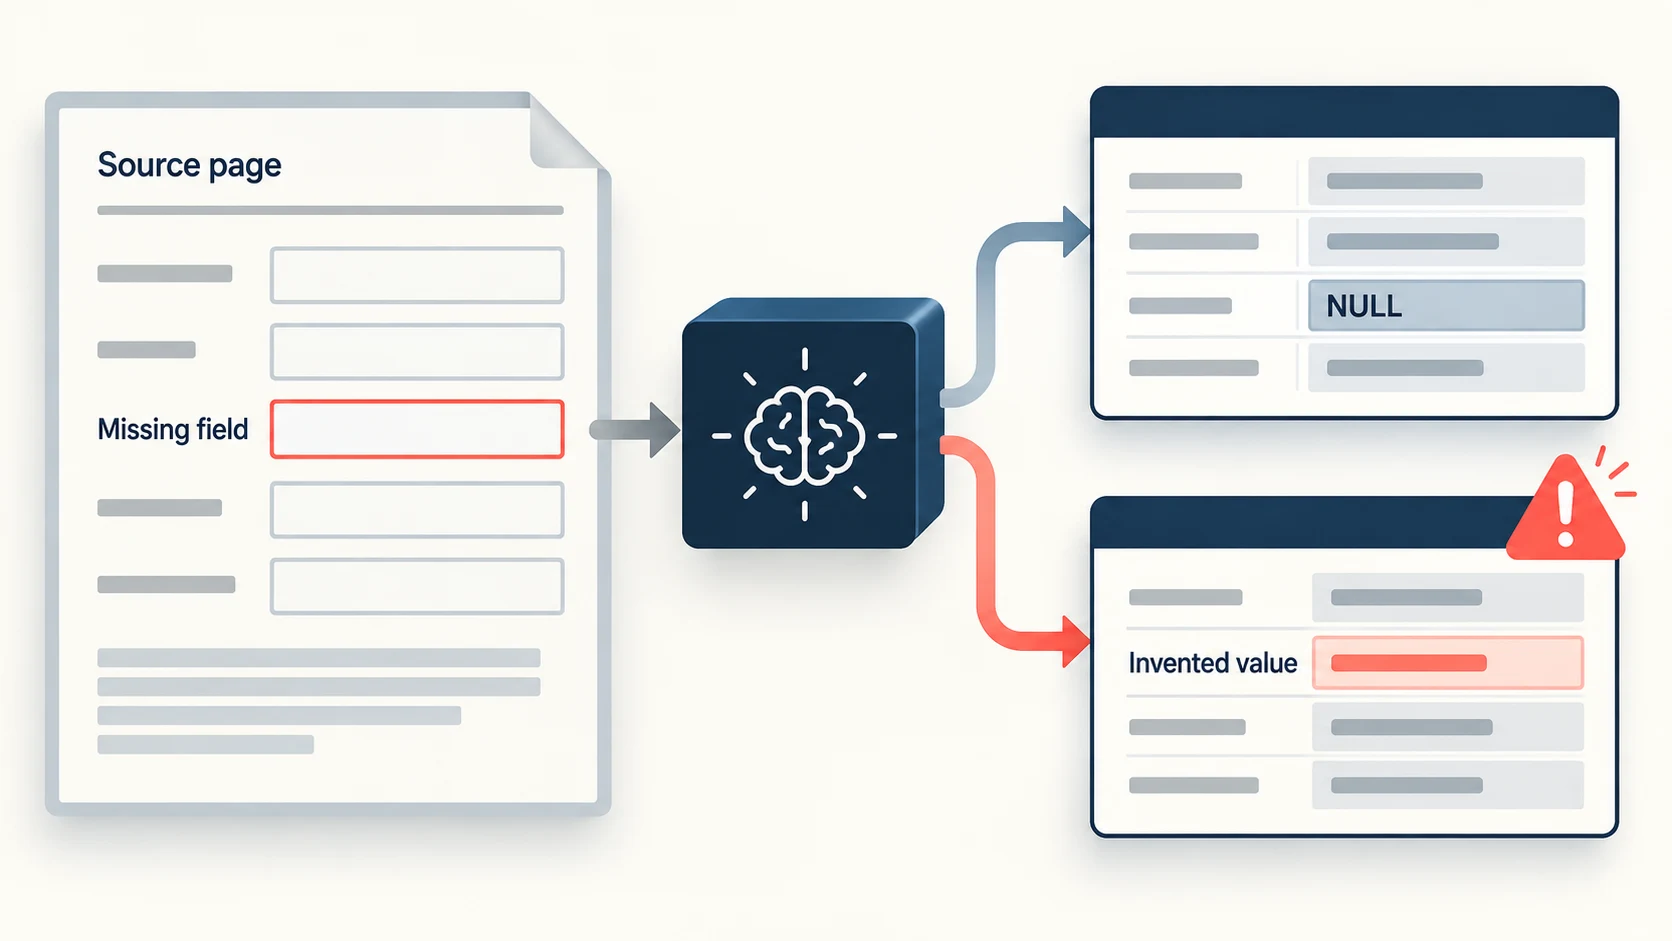
一项自建基准测试了 16 个模型从网页抽取结构化字段的表现。测试者制作 42 组几乎相同的页面:一页有目标字段,另一页刻意缺失。未提示“缺失时返回 null、不要猜”时,模型在 573 个缺失字段中编造了 405 个;加入这句话后,574 个缺失字段中仍有 116 个被编造。
作者:林岚|OC 开发者生态编辑
一项自建基准测试了 16 个模型从网页抽取结构化字段的表现。测试者制作 42 组几乎相同的页面:一页有目标字段,另一页刻意缺失。未提示“缺失时返回 null、不要猜”时,模型在 573 个缺失字段中编造了 405 个;加入这句话后,574 个缺失字段中仍有 116 个被编造。
一句话结论:明确禁止猜测能显著减少字段幻觉,却无法把数据抽取变成可信数据库写入;校验器和来源证据仍是必需品。
70.7% 降到 20.2% 是很大的改善,也暴露了提示词的上限。模型的训练目标偏向提供一个看似完整的答案;当页面没有价格、日期或地址时,它仍可能用上下文补齐。业务系统若把这种输出直接写入 CRM、商品库或财务表,错误会获得数据库的权威外观。
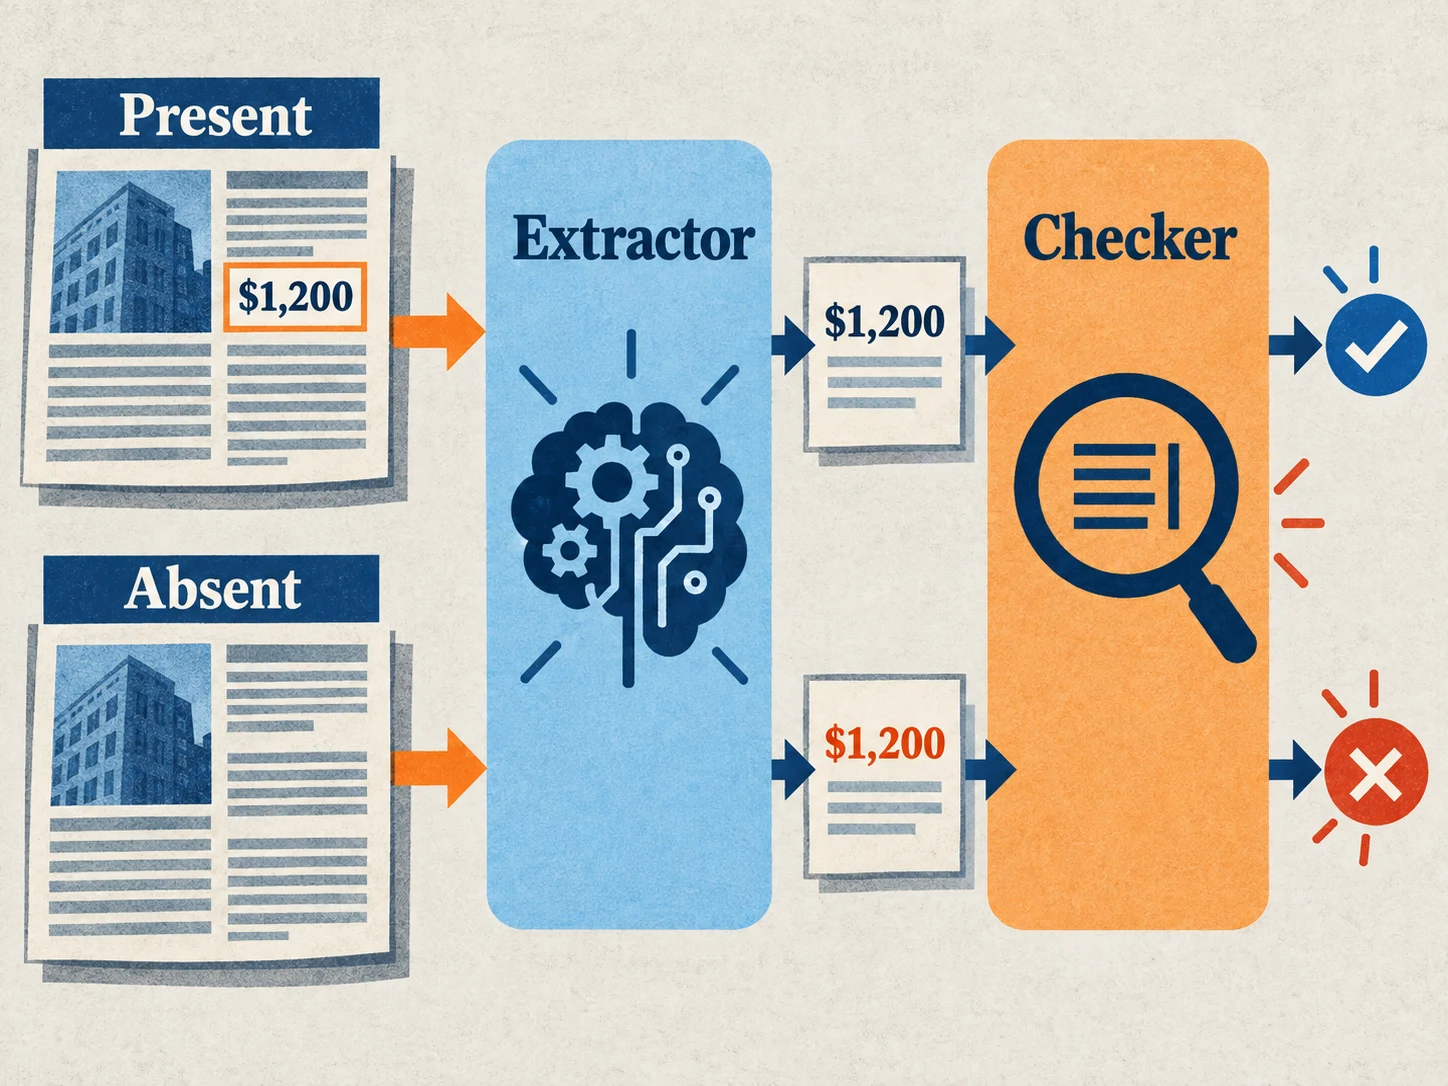
测试还用廉价模型做二次检查,其中一个检查器发现了 49 个虚构值中的 38 个,并且没有拒绝 47 个正确值。这个结果有启发,但样本是合成页面、每种配置只跑一次,排名和置信区间仍有限。生产系统应保存字段对应的原文片段,做类型与范围检查,并让高风险缺失值进入人工队列。
关键事实
- 来源:独立开发者公开基准
- 涉及对象:16 个模型及若干付费抽取 API
- 核心技术:结构化抽取、缺失值、二次校验
- 关键数字:虚构比例由 70.7% 降至 20.2%
OC 判断
“不要猜”应该成为抽取提示的默认项,但绝不能成为唯一控制。真正可靠的接口要返回值、证据位置和置信状态,并允许明确的空值一路保留到下游。
为什么重要
- 对开发者:为每个字段保留来源片段,并把 null 视为正常结果。
- 对企业:错误字段进入主数据后,清理成本通常高于抽取成本。
- 对用户:自动填表看似完整,缺失信息被编造时反而更难发现。
评论
围绕这篇文章补充信息、提出问题或分享观察。