Jevaro 把模型判断变成 Arrow 数据流,吞吐提升不等于判断更准
据 Columnar 项目文章,团队为 TypeSafe AI 的 Jev 构建了 Jevaro 代理,把多个独立状态的判断请求组织起来,再以 Arrow IPC 数据流输出结果。
作者:林岚|OC 开发者生态编辑
据 Columnar 项目文章,团队为 TypeSafe AI 的 Jev 构建了 Jevaro 代理,把多个独立状态的判断请求组织起来,再以 Arrow IPC 数据流输出结果。
一句话结论:Jevaro 探索的是推理接口与分析工具之间的衔接,数据格式和吞吐量的改进并不证明模型判断正确。
Jev 返回的对象包含选择、分值与概率,天然适合进入表格分析。问题是应用层的一次判断,和分析层的批量历史数据,工作单位不同。当前接口针对一个状态回答多个问题;若要验证一批历史记录,仍需要对每个状态分别发起上游请求。
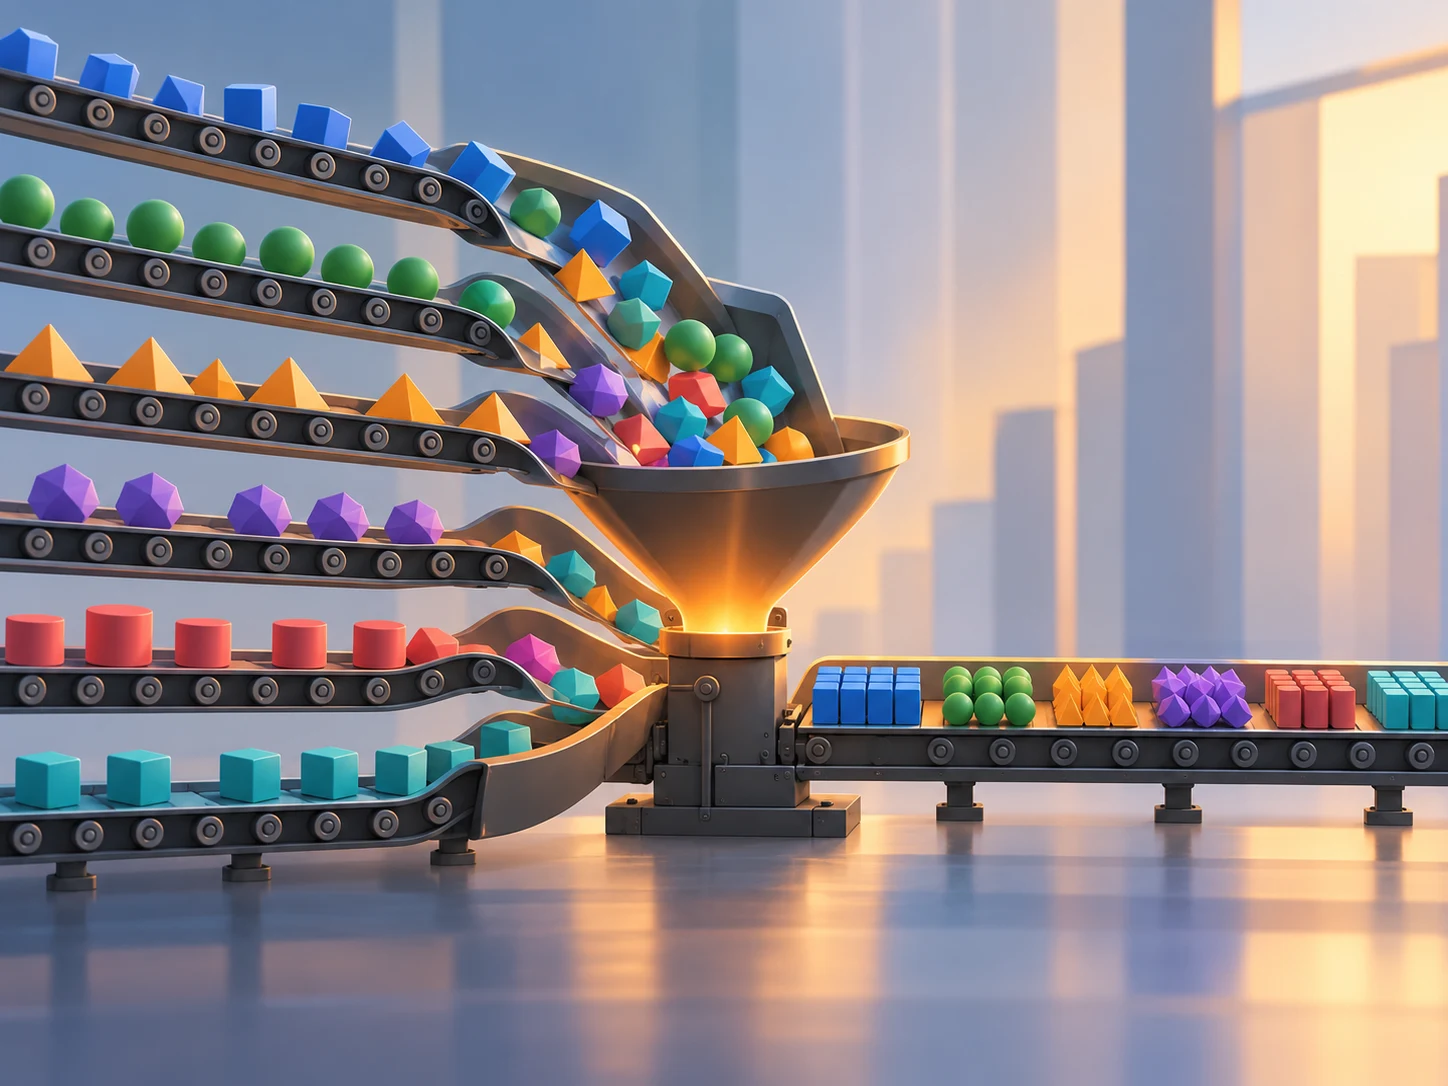
Jevaro 接受多个状态与共同问题定义,使用并发连接、重试和退避调用上游,再把结果按输入顺序送出。它没有把 Jev 变成原生批量接口,上游 JSON 响应与逐条请求仍然存在;代理还增加了一层进程与网络跳转。项目机制说明
Arrow 的价值在于明确的数据类型与批次交换。兼容工具可以直接接收这些结构,减少重新拆解对象、再拼成列的工作。Apache Arrow 官方格式说明也把 IPC 定义为结构化消息与记录批次的交换机制,它并不负责验证模型答案的语义。Arrow 格式文档
作者使用一万条合成消息、每条三个问题做了吞吐实验,最快一轮约 21.5 秒。这是特定请求、限流条件与实现下的工程测量,不能外推为生产业务的固定性能,更不是判断准确性评测。文章对原生接口未来可能更快的描述,也属于预期。
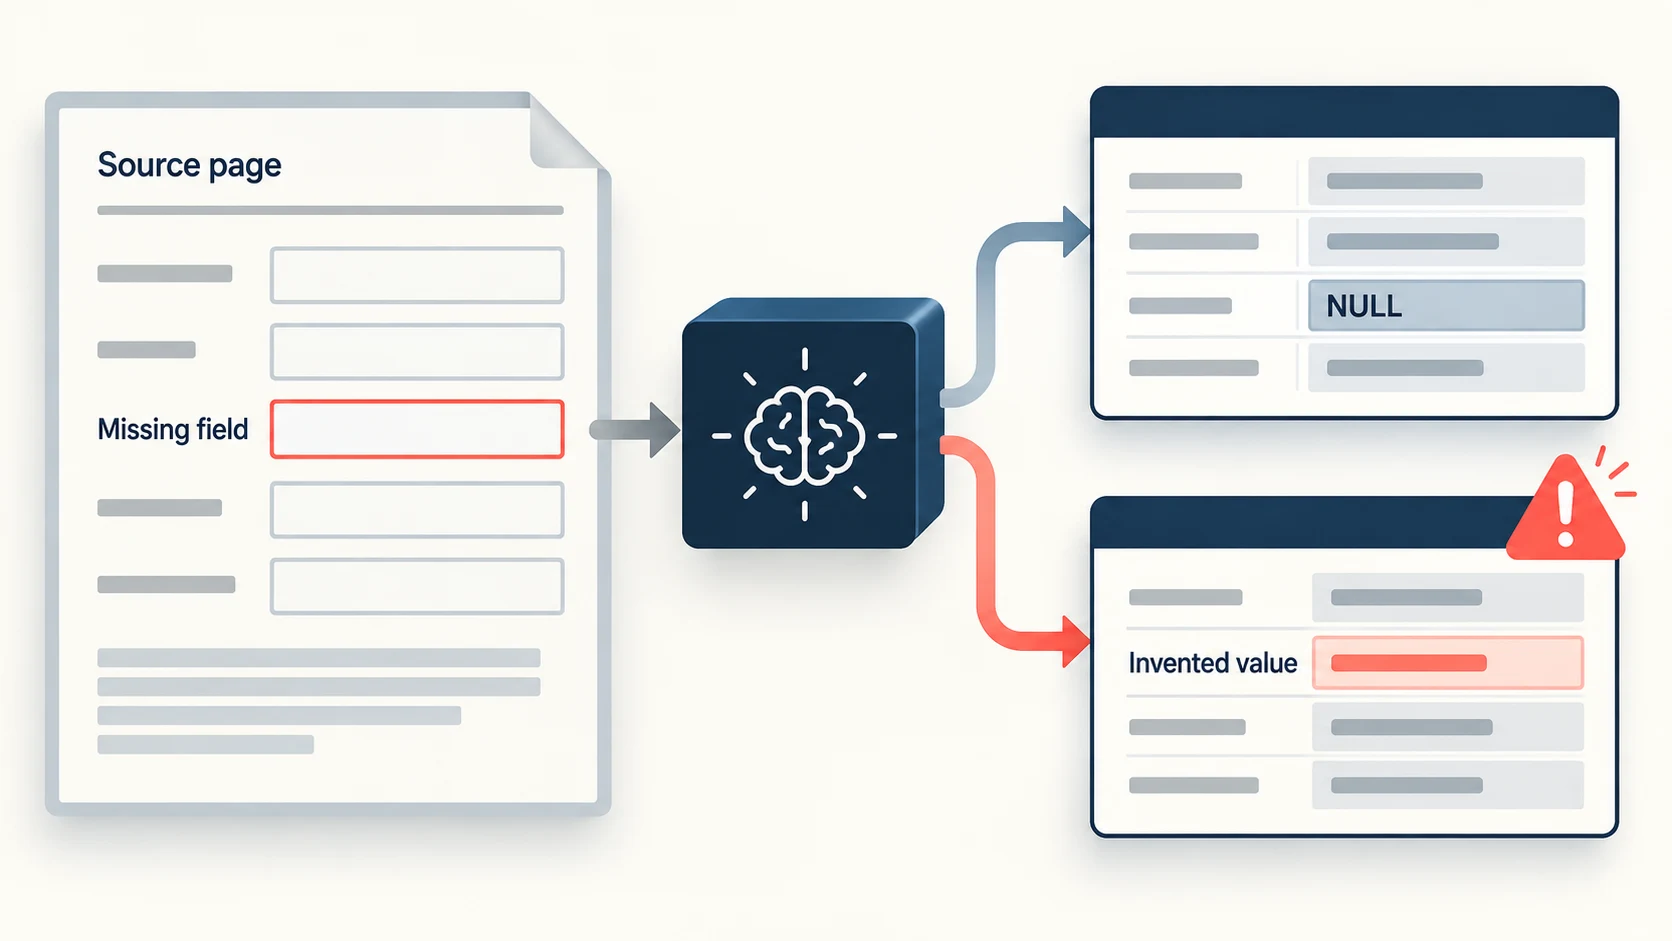
按输入顺序返回有利于对齐历史记录,却可能让一个慢请求挡住后面的结果。开发者需要根据业务选择有序输出还是带标识的乱序输出,并记录失败、重试及缺失结果。更重要的是把预测与真实结果放到一起验证:格式正确和概率字段完整,仍不能保证概率经过校准。
关键事实
- 来源:Columnar 的 Jevaro 实验文章与 Apache Arrow 文档。
- 涉及项目:Jev、Jevaro、Apache Arrow。
- 核心技术:并发代理、结构化模型判断与 Arrow IPC 流。
- 关键边界:合成数据吞吐实验没有证明实际分类质量或原生接口性能。
OC 判断
AI 接入数据工作流时,明确的类型和稳定的批次处理非常有用。最值得保留的设计是让答案可验证、可比较;更快地写出错误判断不会改善业务。
为什么重要
- 对开发者:可以把模型输出接入现有分析生态,并独立测试判断质量。
- 对企业:需要同时记录推理成本、处理失败与实际业务误差。
- 对用户:结构化结果便于追溯,仍应提供纠正错误的入口。
评论
围绕这篇文章补充信息、提出问题或分享观察。