ProVer尝试定位代理关键决策,奖励判断先用续跑验证
据 ProVer 研究论文 预印本,研究者提出 ProVer,为代理强化学习中的部分关键决策分配更细粒度的训练信号。
作者:林岚|OC 开发者生态编辑
据 ProVer 研究论文 预印本,研究者提出 ProVer,为代理强化学习中的部分关键决策分配更细粒度的训练信号。
一句话结论:模型先建议检查哪里,再用后续结果验证,是减少错误归因的一条研究路径。
长任务的成功通常由多个步骤共同形成。如果把最终成功或失败的同一个奖励信号平铺到整条轨迹,训练很难区分哪些动作真正改变结果,哪些只是伴随出现。关键决策的定位因此影响学习效率。
ProVer 先比较成功与失败轨迹,让评审代理提出可能解释差异的片段。它没有直接把评审意见当作事实,而是在片段前后抽样续跑,通过最终成功率差异估计这段决策的优势。
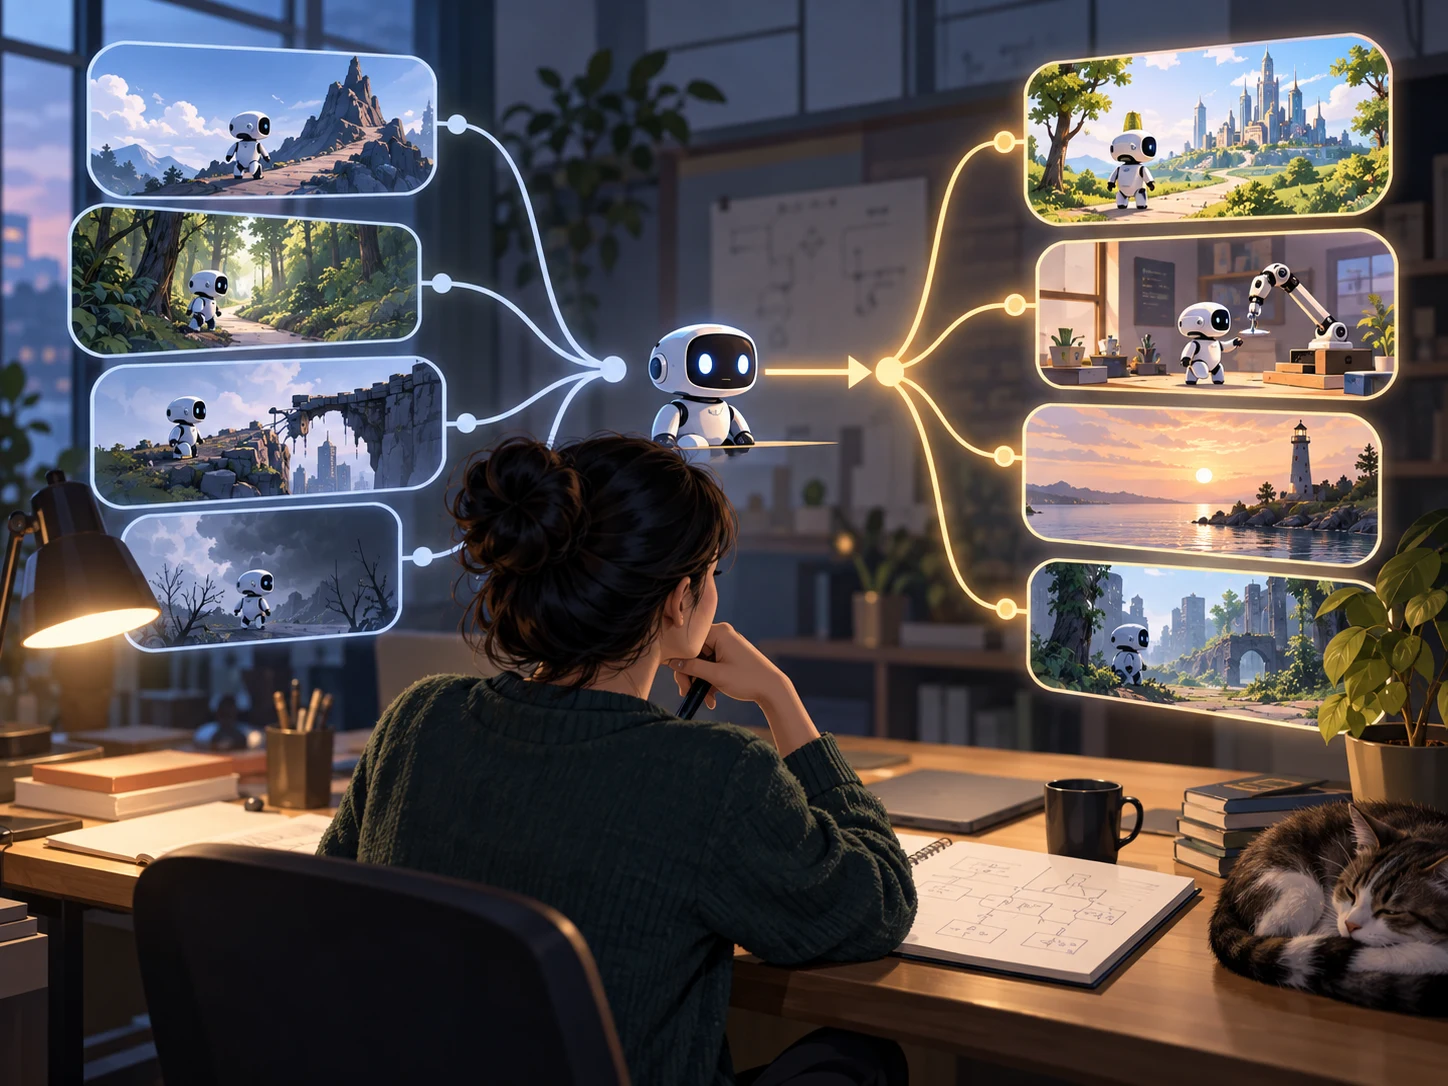
这种设计把模型判断用于选择验证位置,而不是替代所有验证。它可能减少逐一评估每个中间状态的成本,但结果仍受续跑次数、环境和估计噪声影响。观察到概率差异,也不是对现实世界因果关系的完整证明。
论文在 ALFWorld、WebShop 与 SearchQA 上测试,报告两个模型规模相对 GRPO 的平均改善为 9.91% 和 7.12%。这些是特定模型、基准和训练设置下的研究结果,不能外推成所有代理都将提升同一比例。
工程团队更值得借鉴的是验证分工:先用便宜的信号定位问题,再把资源投入少数值得检查的步骤。生产任务还需考虑环境是否可重置、工具动作能否安全重试,以及训练环境与真实使用的差异。
关键事实
- 性质:2026 年 9 月提交的研究预印本。
- 方法:评审提出片段,续跑结果估计局部优势。
- 边界:三个基准、两个模型规模,未证明通用生产收益。
OC 判断
更细的奖励信号有望减少无关步骤干扰。研究价值在于用可观察结果约束评审,而非赋予模型不可质疑的归因能力。
为什么重要
- 对开发者:检查局部估计的噪声与额外计算成本。
- 对企业:将可重置测试环境与生产动作分开。
- 对用户:代理可靠性应由真实任务验证。
评论
围绕这篇文章补充信息、提出问题或分享观察。