AI 研究
OurCoders 科技频道关于“AI 研究”的内容分类,共收录 11 篇稿件。
最新新闻
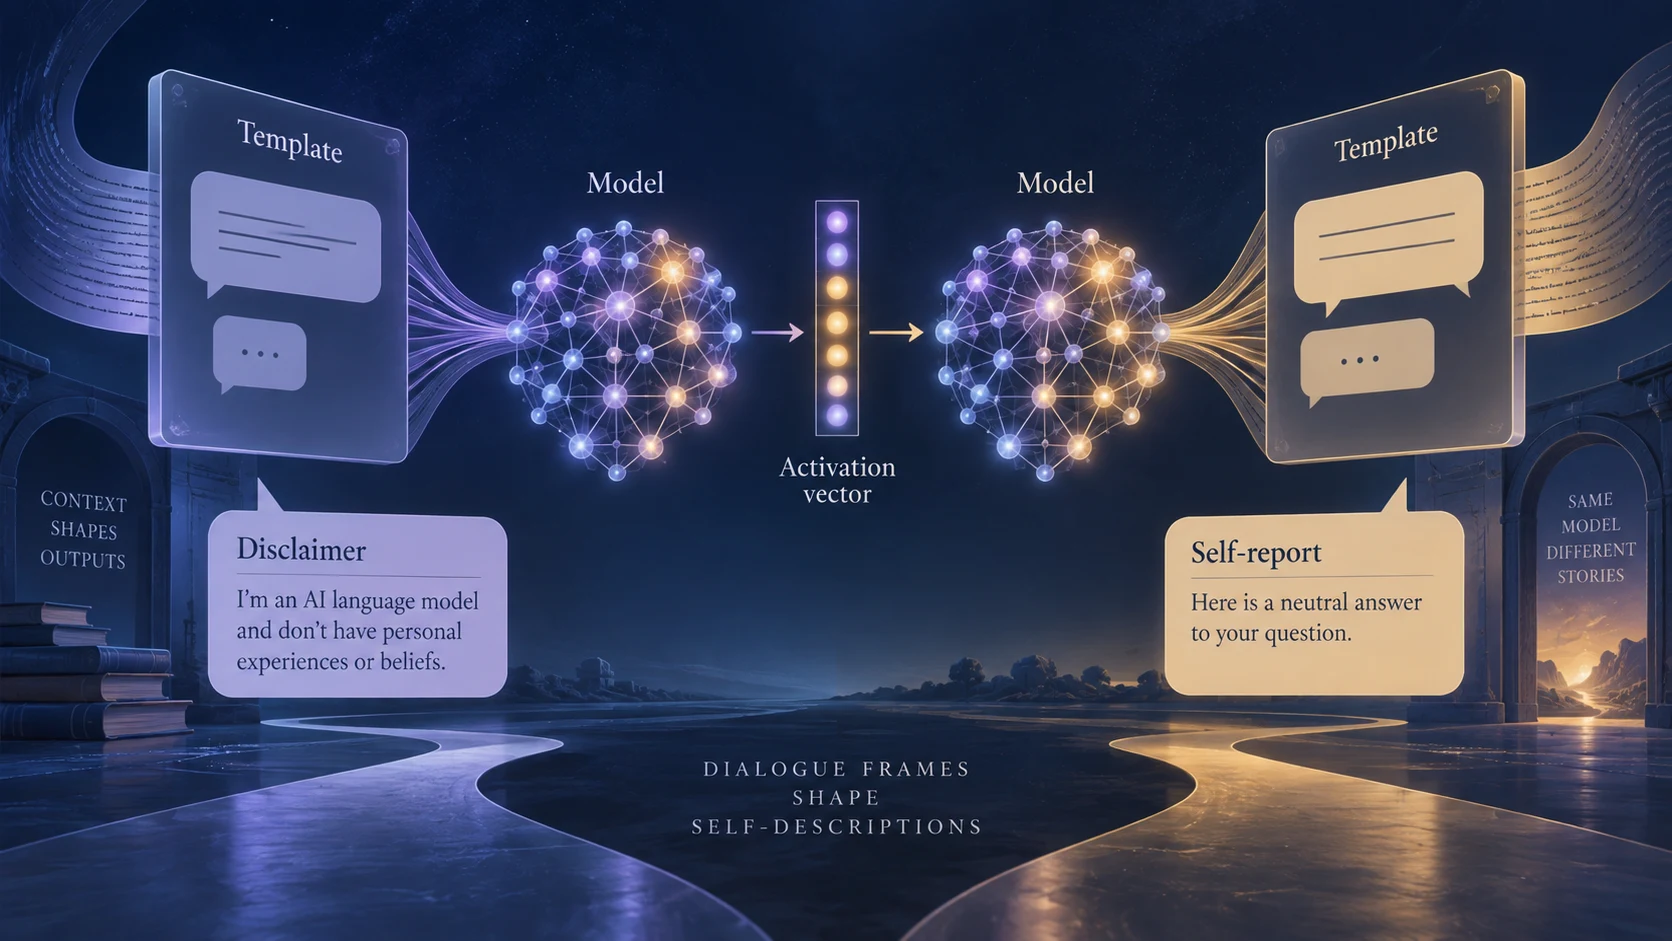
同一个模型换套聊天模板就换了“自我口吻”,免责声明也是部署行为
一篇新论文研究了八个不超过 9B 参数的主流开源指令模型。研究者发现,给同一个模型套上聊天模板后,它更常说“我只是一个 AI”一类免责声明,也更少使用“我感觉”式体验语言。研究还在三个模型里找到相关激活方向;加入或移除这一方向,可以推动相似的语言变化。
Apple LensVLM 先看压缩页面再展开,长文档阅读开始分配注意力预算
据 Apple 的 LensVLM-9B 模型卡与论文页面,该模型先扫描文字的压缩图像,再通过学到的工具选择需要展开的页面。相关论文已于 5 月公开,近日模型资料进入开发者讨论。
模型说话更客气,为什么还要另测偏见
据 9 月 17 日提交 arXiv 的预印本,杜伦大学研究者分析了 GPT-2 至 GPT-5 系列 15 个模型的 45 万条性别定向生成文本,提出“harm laundering”这一描述:显性有害措辞下降时,表征偏差可能换一种形式继续存在。它是一项特定模型谱系、特定提示设计下的研究,不是所有 AI 越升级越歧视
Anthropic 让 AI 研究员改进十类对齐失败,但这还不是“自我进化”
据 Anthropic 发布的研究说明与完整报告,研究团队让自动化研究系统针对十类可测量的模型对齐失败寻找改进方法。系统会检索文献、提出方案、进行约 30 分钟的训练实验、运行评测,并在多轮迭代中保留有效方法。十项指标都得到改善,且没有观察到整体能力下降。
没有总指挥的 AI 数学团队做出了新结果,但“突破”仍要人类验算
据论文 《Autonomous Mathematical Discovery in an Open-World Multi-Agent Environment》,研究团队让来自不同模型家族的 Agent 在 Station 环境中自主选择方向、开展计算实验、互相交流,并把结果写入共享文献。系统测试了 12 个来自 Al
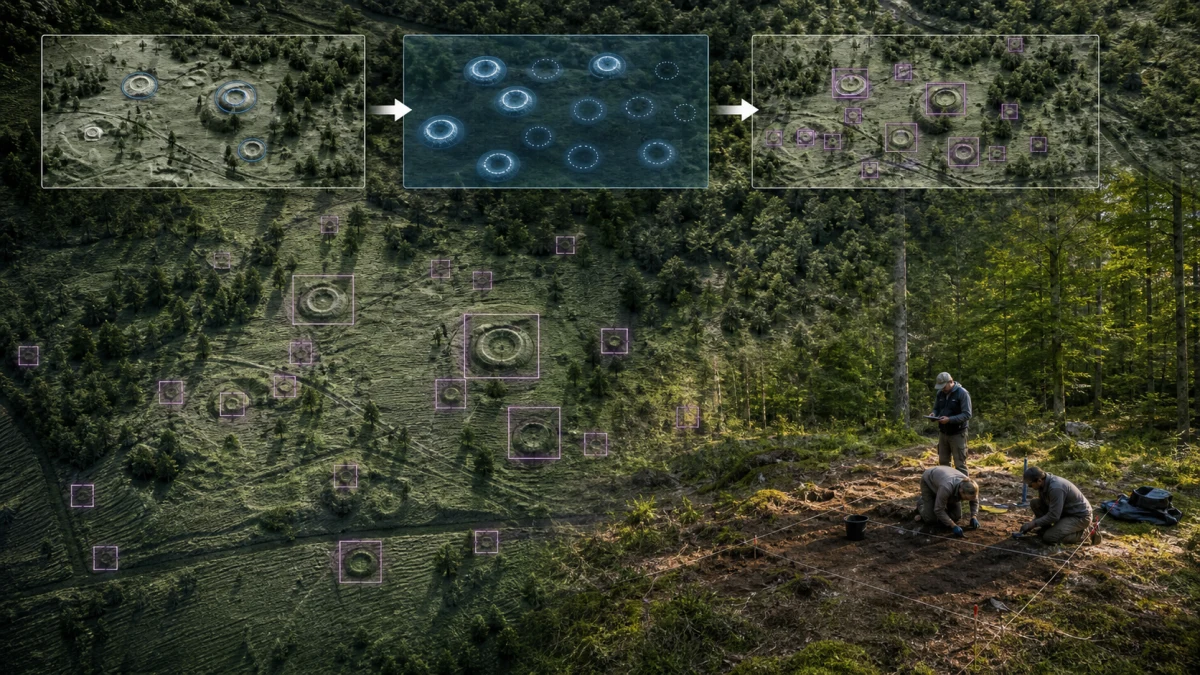
只有十二个遗址样本,考古团队如何用模拟地形训练 AI
一项发表于《Advances in Archaeological Practice》的研究尝试解决小样本考古识别问题:团队把程序生成的考古结构嵌入真实 LiDAR 数字高程模型,再用这些合成样本训练 Mask R-CNN,寻找路易斯安那州森林中的圆形地表特征。

只学到五年级的语言模型:扩大训练也补不回被过滤的知识
作者:韩启明|OC 政策与安全编辑

Claude 能识别被注入的内部概念:这不是模型产生了意识
作者:林岚|OC 开发者生态编辑

Claude 找到 HAWK 和 AES 弱点:AI 会做密码学研究,不等于加密已被攻破
作者:韩启明|OC 政策与安全编辑

把马里奥教会五步,离会通关还很远:JEPA 世界模型撞上了规划难题
OC 原创示意图。

Rich Sutton 警告 Agent:别以为预测好下一步,就能推演整个未来
作者:陈墨