Apple LensVLM 先看压缩页面再展开,长文档阅读开始分配注意力预算
据 Apple 的 LensVLM-9B 模型卡与论文页面,该模型先扫描文字的压缩图像,再通过学到的工具选择需要展开的页面。相关论文已于 5 月公开,近日模型资料进入开发者讨论。
作者:林岚|OC 开发者生态编辑
据 Apple 的 LensVLM-9B 模型卡与论文页面,该模型先扫描文字的压缩图像,再通过学到的工具选择需要展开的页面。相关论文已于 5 月公开,近日模型资料进入开发者讨论。
一句话结论:减少一次读入的细节之后,系统还必须知道何时回到原文。
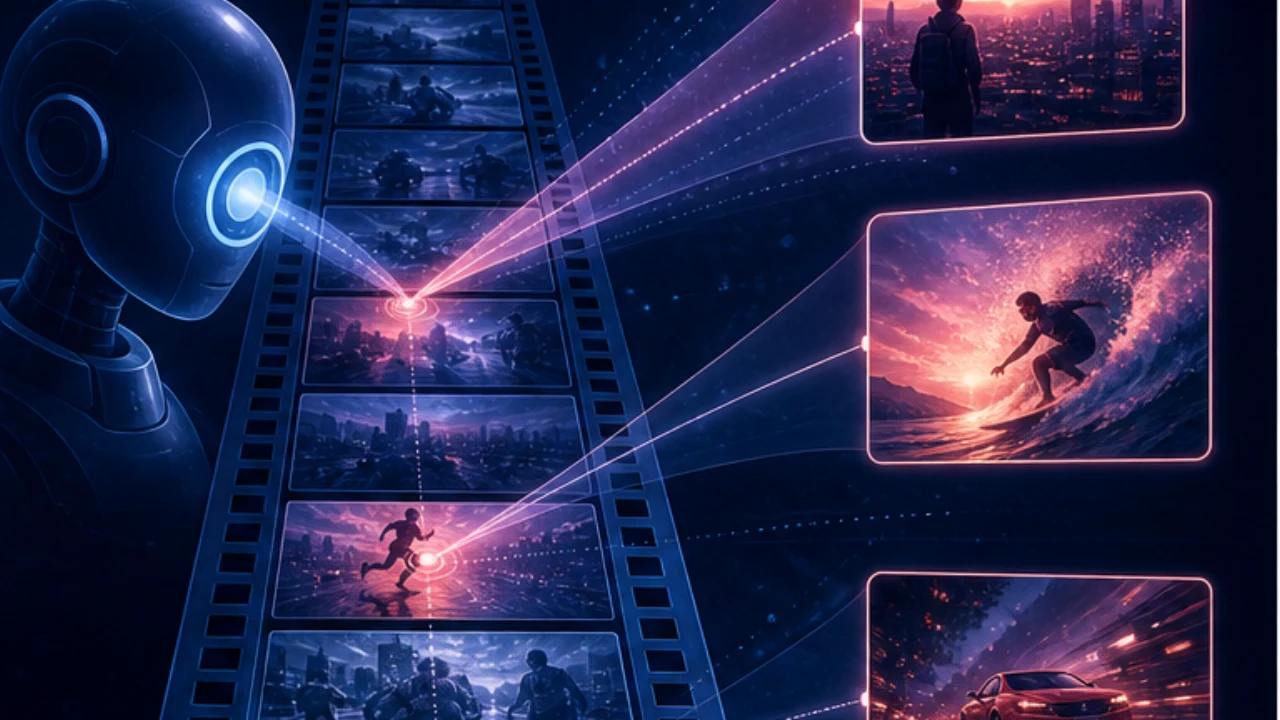
长文档不一定每一页都与当前问题有关。LensVLM 尝试先用视觉表示浏览压缩后的内容,再把更相关的部分恢复到较完整的形式。它把“读哪些细节”变成模型执行的一部分,而不是从头到尾用同一种精度处理。
论文报告,在七项文本问答基准上,约 4.3 倍有效压缩下的表现接近全文输入参考结果。这个数字描述特定评估中的上下文表示,并不等于推理时间、显存或账单都降低为原来的四分之一。图像处理和展开操作本身也有成本。
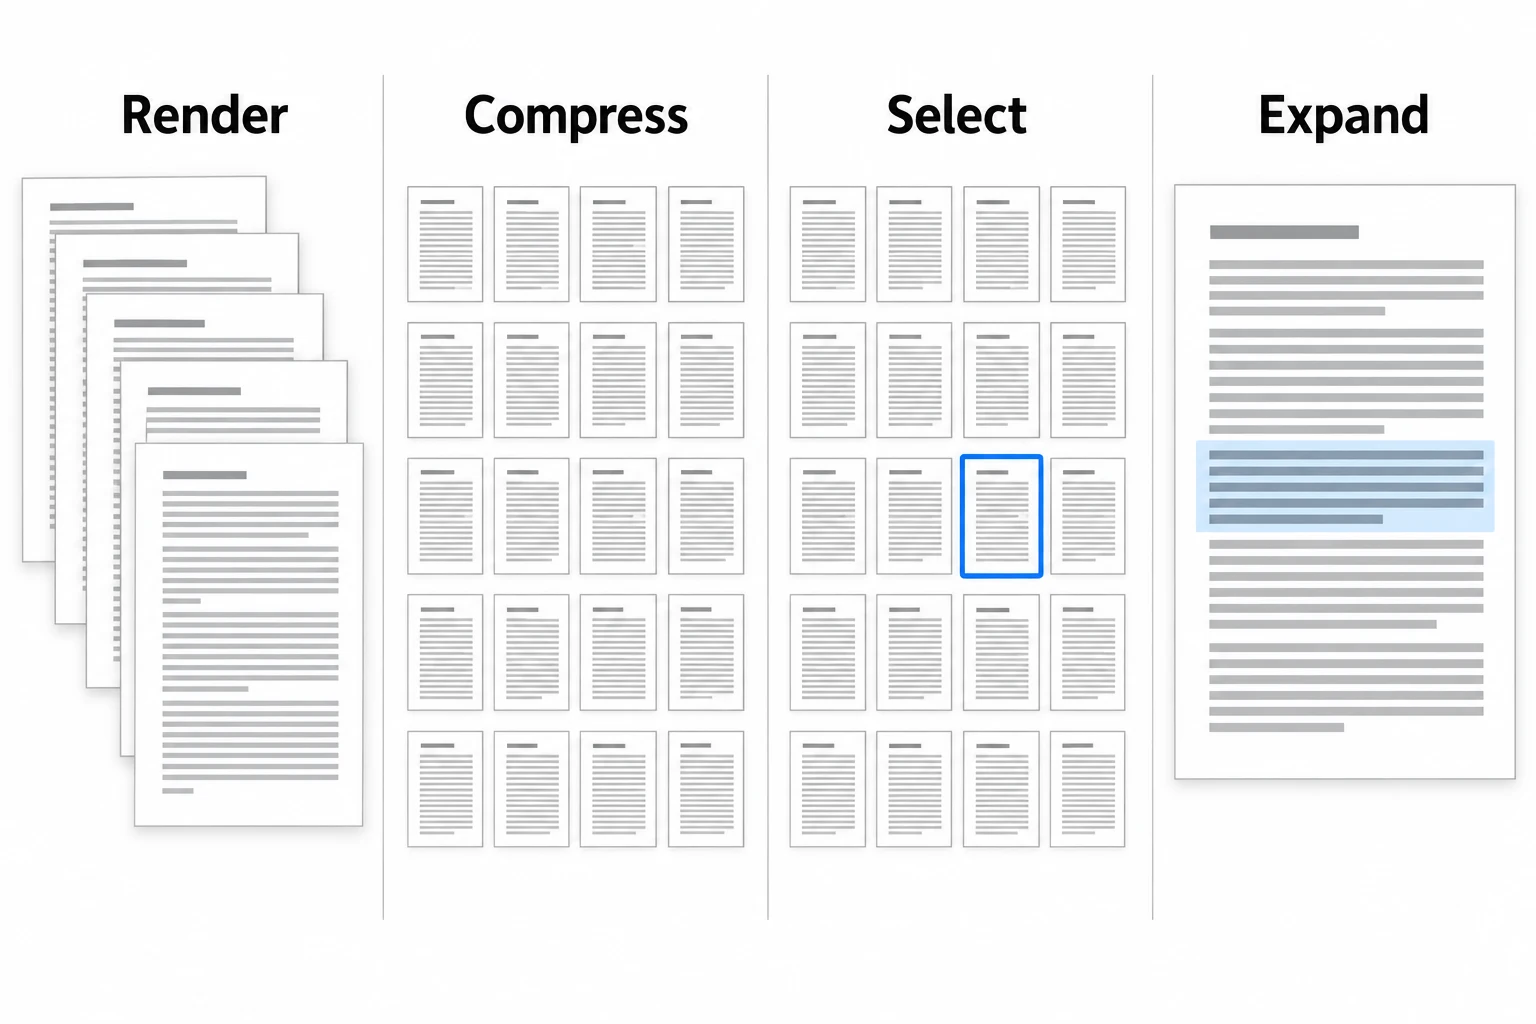
一个读合同的系统,如果在概览阶段漏掉页脚的例外条款,后面即便把别处读得再仔细,也可能答错。因此,选择性展开需要和证据定位一起评估:模型引用的是哪一页,关键限定是否被保留,遇到不确定问题会不会主动补读。
模型卡列出 9B 规模,并给出代码与模型的不同许可安排。能下载权重不应直接写成没有限制的通用开源许可;用于产品前还需要阅读相应条款。
这项研究的启发是让文档预算随问题分配。对于需要完整覆盖的审计、逐条比对等任务,选择性读取未必适合替代全量检查。一个方法能高效回答局部问题,不代表它已经证明整份文件没有遗漏。
关键事实
- 来源:Apple 模型卡、arXiv 论文。
- 时间:论文为 2026 年 5 月公开,非当日首次发表。
- 指标:4.3 倍有效压缩属于研究基准口径。
OC 判断
文档压缩真正值得关注的,是压缩之后怎样恢复证据。产品如果能展示选择与展开过程,用户就更容易发现它漏看了什么;如果只给一个流畅答案,信息损失仍然很难察觉。
为什么重要
- 对开发者:同时测量答案、引用定位与展开开销。
- 对企业:按问答和完整审阅两类任务分别验收。
- 对用户:重要结论仍需要能够回到原文确认。
评论
围绕这篇文章补充信息、提出问题或分享观察。