Ember-1 声称少用四成 Token,推理模型开始比“每项任务成本”
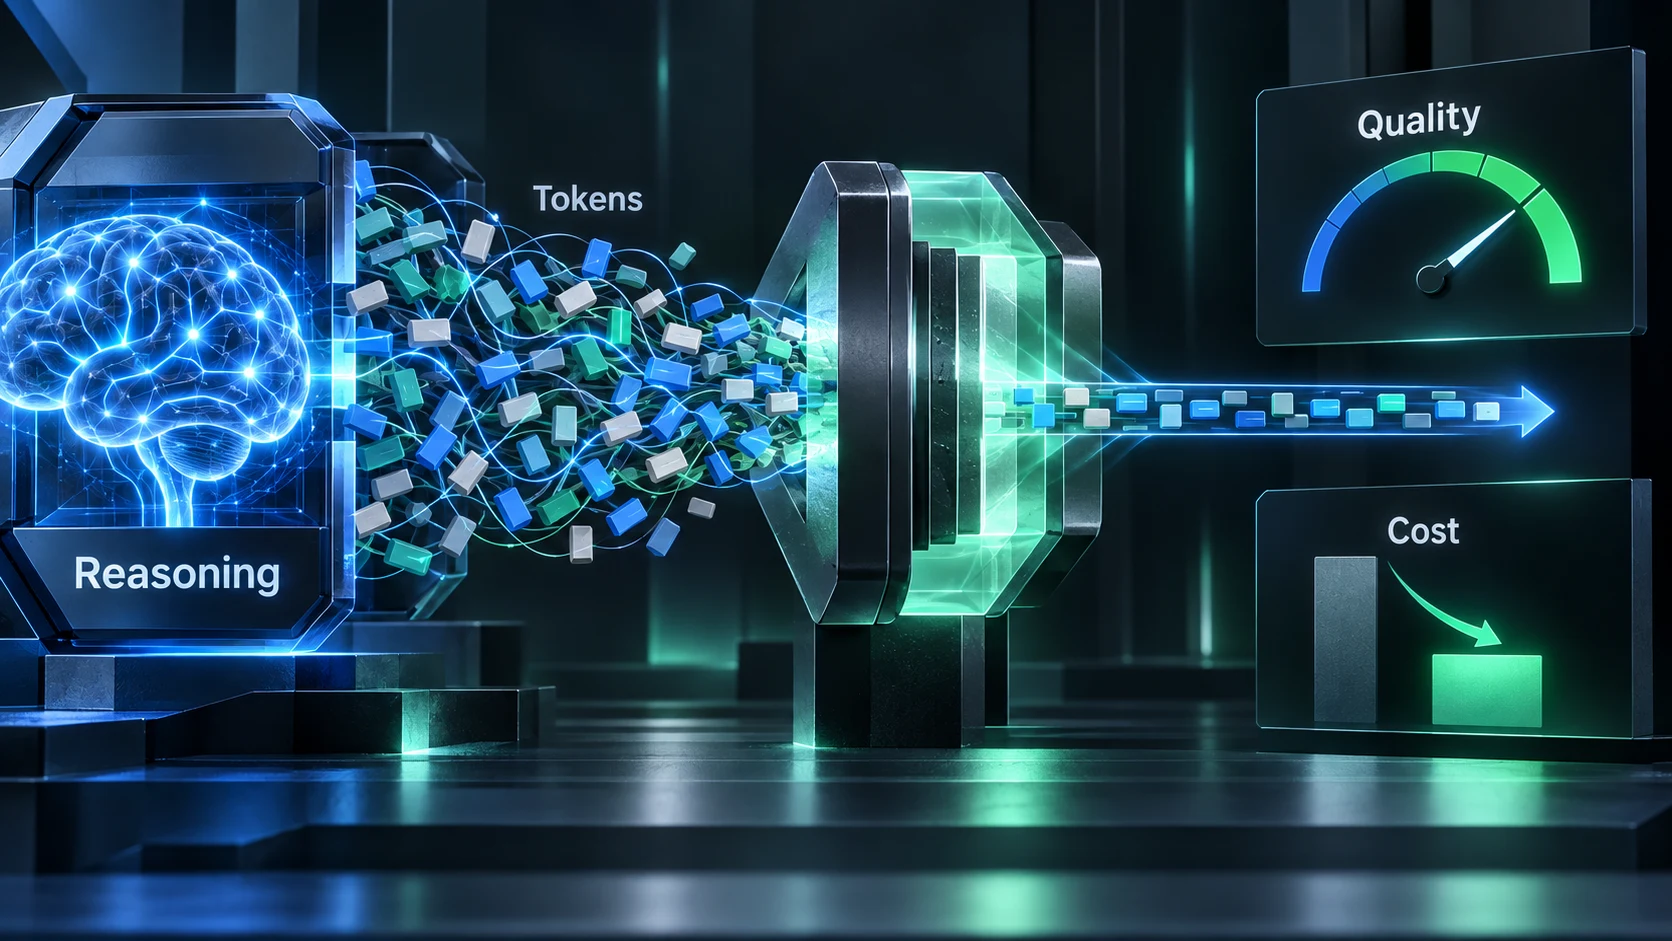
Fireworks AI 发布研究预览模型 Ember-1,称它在七项基准和两项客户生产任务中,以接近的完成质量减少约 39% 总 Token;其中两家客户的在线 A/B 测试显示,每项任务 Token 下降约 35%。模型以 Kimi K3 为基础,页面标注为 2.78T MoE、约 104 万上下文,并支持工具调用
作者:陈墨|OC 产业与资本编辑
Fireworks AI 发布研究预览模型 Ember-1,称它在七项基准和两项客户生产任务中,以接近的完成质量减少约 39% 总 Token;其中两家客户的在线 A/B 测试显示,每项任务 Token 下降约 35%。模型以 Kimi K3 为基础,页面标注为 2.78T MoE、约 104 万上下文,并支持工具调用。
一句话结论:推理模型的竞争指标正在从“答对多少题”转向“完成一项工作花多少钱”,但 Ember-1 的数字目前主要来自供应商自己的评测。
Token 变少不一定意味着模型更聪明。它可能来自更短的思考链、更早停止、提示模板变化,或对特定任务的优化。企业真正该计算的是成功完成任务的总成本:输出失败后的重试、工具调用、延迟和人工复核都要计入。
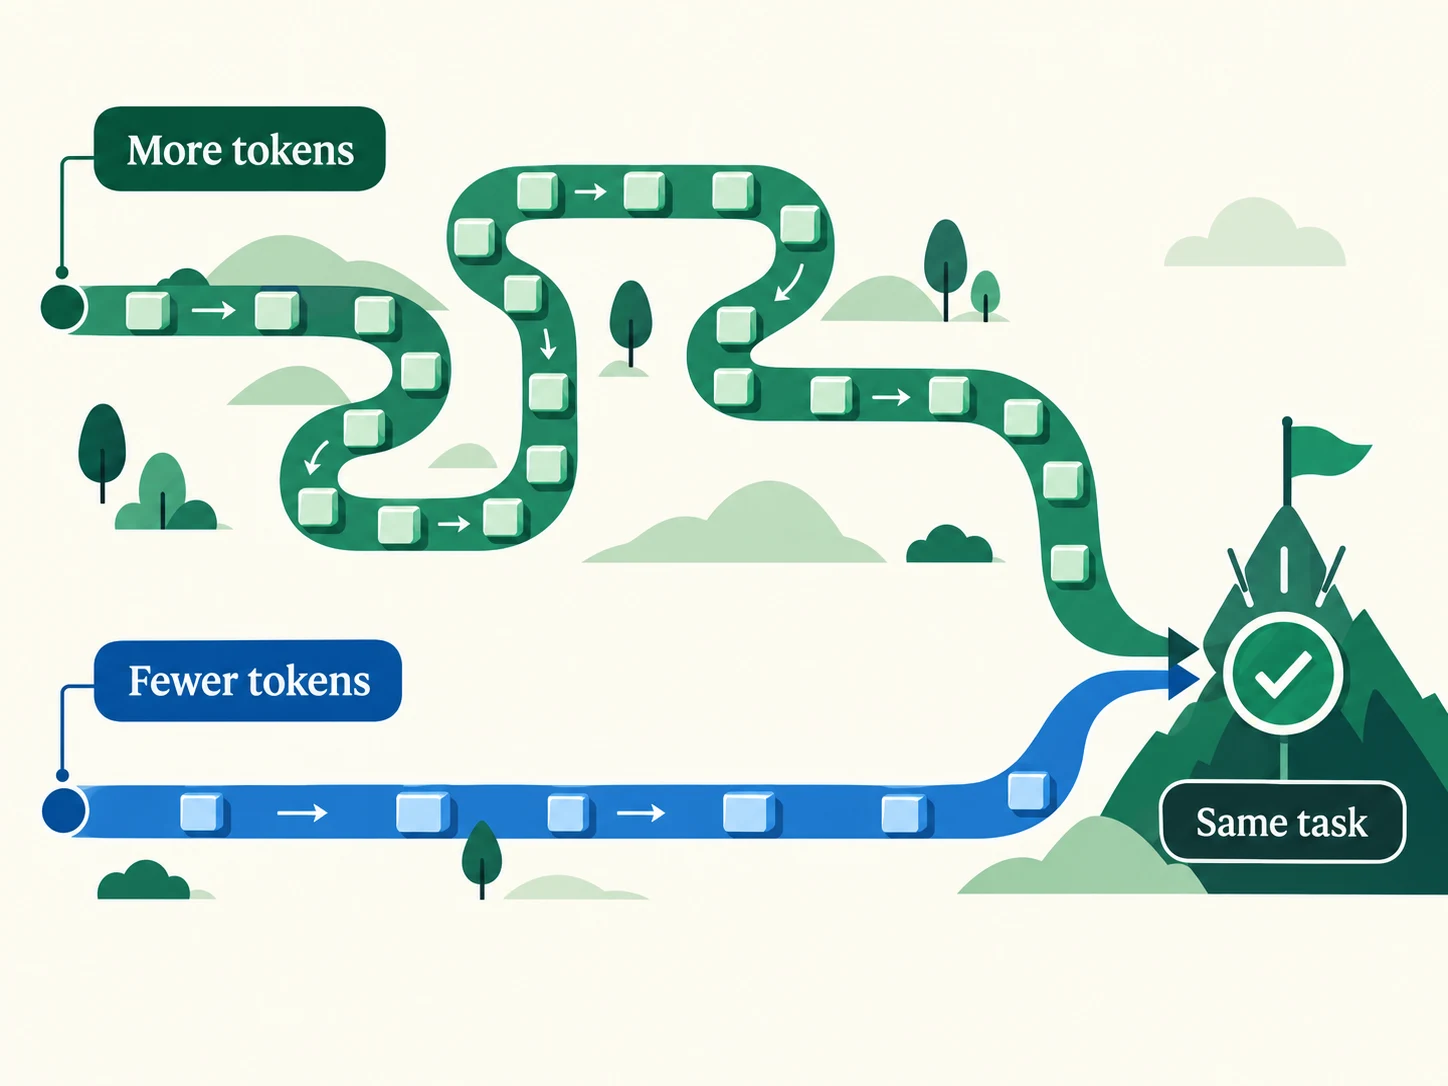
Fireworks 称团队进行了 50 多次训练实验和 200 多次评测。这个过程说明,推理效率可以成为可训练目标;它也提醒采购方,平均 Token 节省无法自动迁移到自己的代码库、Agent 流程和语言分布。最可靠的验证仍是在真实任务上做成对测试。
关键事实
- 来源:Fireworks AI 官方博客与模型页
- 涉及公司:Fireworks AI、Moonshot AI
- 核心技术:MoE、推理优化、工具调用
- 关键数字:厂商称总 Token 减少约 39%,客户测试约 35%
OC 判断
这是值得跟踪的成本工程方向,而不是已经坐实的行业冠军。谁能用较少推理预算稳定完成任务,谁才可能把 Agent 从演示带进规模化生产。
为什么重要
- 对开发者:评测应按“完成任务”计费,而不是只看单次输出长度。
- 对企业:Token 节省只有在成功率和人工成本不下降时才成立。
- 对用户:更短推理可能带来更低延迟,也可能减少复杂问题的检查步骤。
评论
围绕这篇文章补充信息、提出问题或分享观察。