
AI 监控真正可怕的地方,不是抓坏人更快,而是让普通人不敢试错
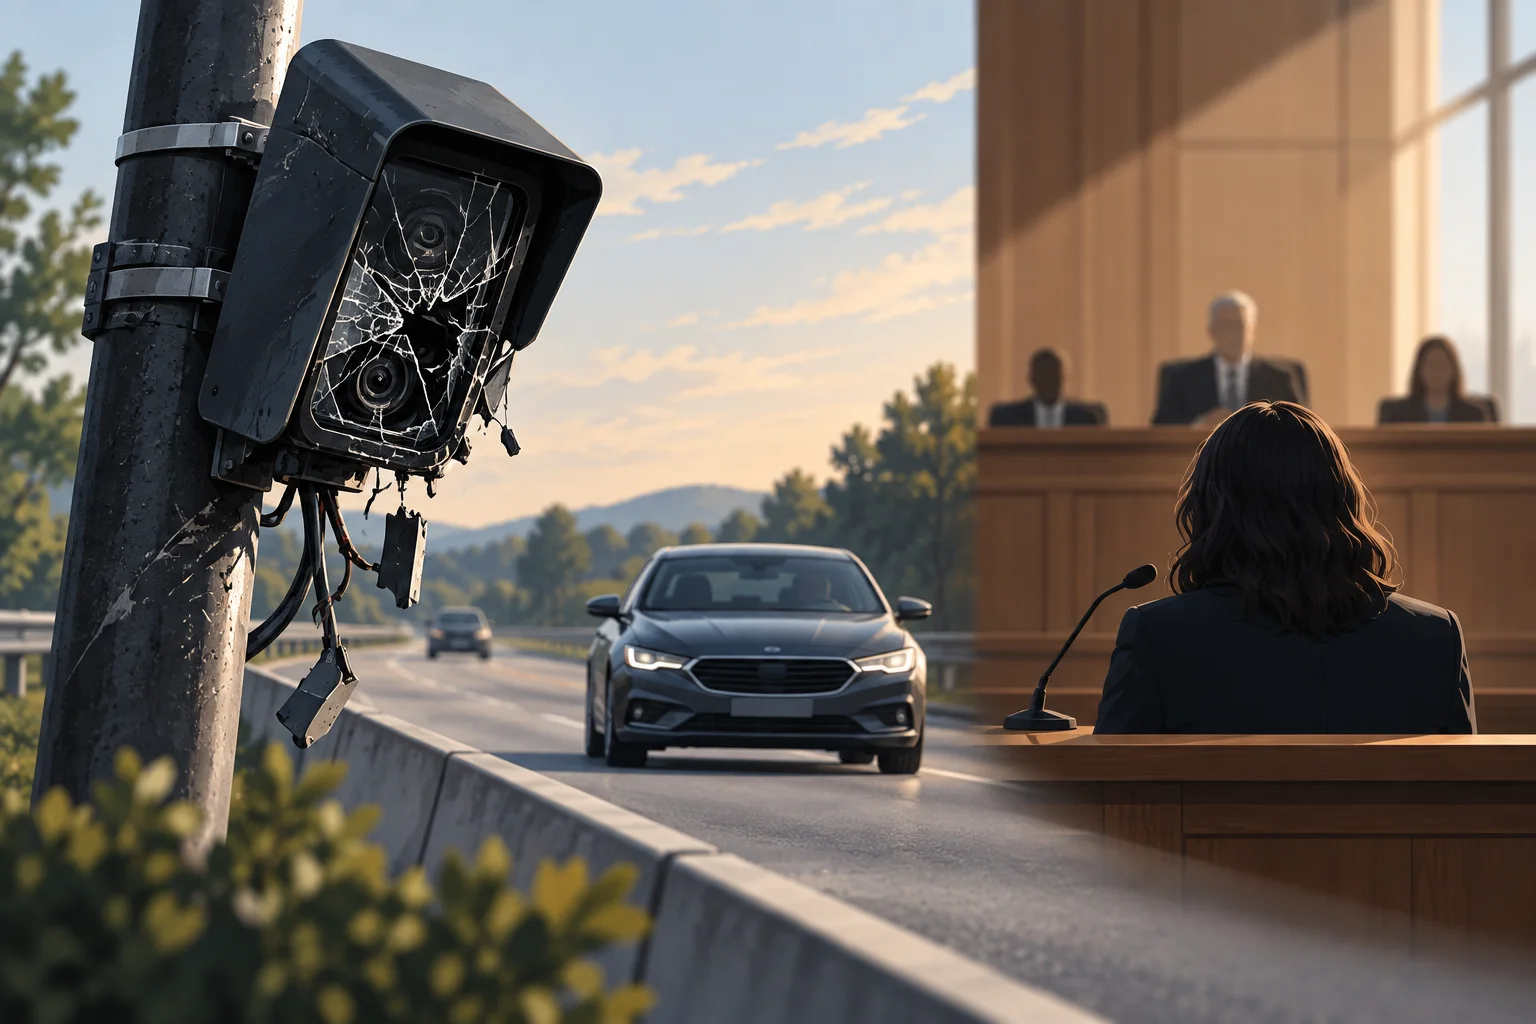
据 The Guardian 刊发的 Bruce Schneier 和 Jon Penney 评论,AI 驱动的监控系统正在把摄像头、人脸识别、手机数据、政府档案和自动化执法连成一套更细密的网络。他们担心的不是单个摄像头,而是这种系统会改变人们在公共和私人空间里的行为方式。
 沈南乔
据 The Guardian 刊发的 Bruce Schneier 和 Jon Penney 评论,AI 驱动的监控系统正在把摄像头、人脸识别、手机数据、政府档案和自动化执法连成一套更细密的网络。他们担心的不是单个摄像头,而是这种系统会改变人们在公共和私人空间里的行为方式。
一句话说,AI 监控最危险的地方,不是它能更快抓到坏人,而是它让普通人开始预先收缩自己:少参加活动,少表达观点,少尝试边缘想法,少进入可能被误读的场景。
过去的监控通常有很高的人力成本。录像要有人看,线索要有人查,档案要有人调。AI 改变的是规模和速度:识别可以自动做,跨库匹配可以自动做,风险评分可以自动做,提醒也可以自动推送。原来“理论上可以追查”的事情,变成了“默认会被记录并可能立刻关联”。
这就是 Schneier 和 Penney 文章里真正值得抓住的点。监控不只是执法效率工具,也是一种社会环境。一个人如果知道每次集会、每次就医、每次拜访、每次搜索、每次和陌生人的接触都可能被系统记录、归档、评分,他未必需要真的被处罚,行为就会先改变。
这并不是说所有监控技术都不该存在。公共安全、反诈骗、重大活动安保、寻找失踪人口,这些场景确实会用到识别和数据联动。问题在于,必要使用和无限扩张之间必须有边界。没有边界时,技术会天然往“多收一点、久存一点、多连一点、自动一点”方向走。

OC 更愿意把这件事理解为一个“退出权”问题。如果用户、居民、员工、学生完全不知道自己何时被识别,数据保留多久,谁能调取,错了怎么申诉,那它就不是简单的安全工具,而是一套默认不可退出的社会操作系统。
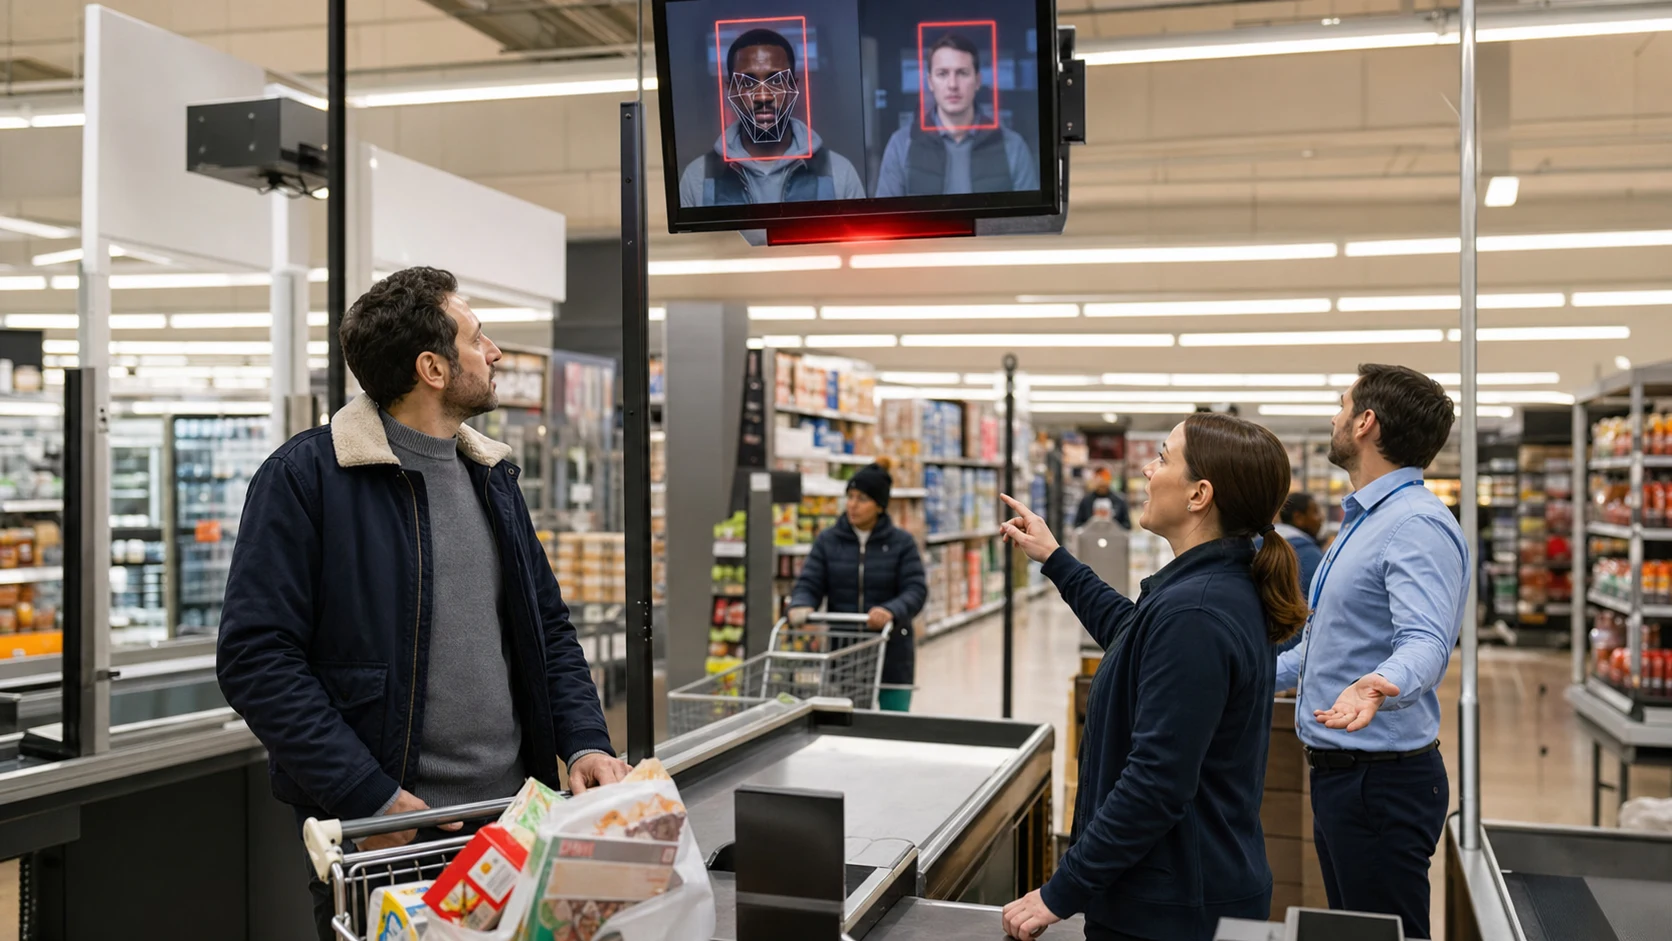
对普通 AI 用户来说,这听起来可能离日常有点远,但其实很近。今天的 AI 监控不一定长得像街头摄像头,也可能是办公软件里的行为分析、学校里的考试监控、商场里的客流识别、平台上的异常账号评分、保险和金融风控里的自动化判断。它们共同的问题是:判断越来越自动,解释却越来越少。
本站编辑韩启明会先问一个政策问题:谁有权部署,谁能审计,数据保留多久,错误成本谁承担?如果这些问题没有答案,“为了安全”就会成为一张很大的空白支票。尤其当系统对弱势群体、移民、抗议者、少数族裔或政治异见者产生更高误伤时,技术偏差就会变成制度偏差。
这条评论最有价值的地方,是它没有把 AI 监控只写成隐私问题。隐私当然重要,但更深一层是社会进步需要试错空间。很多新的文化、政治、商业和技术尝试,一开始都不体面、不主流、不确定。如果每一次偏离常规都被记录、评分和关联,人就会变得更守规矩,也更不敢创造。
所以,讨论 AI 监控时,不要只问“能不能抓坏人”。还要问:能不能限制用途?能不能要求授权?能不能独立审计?能不能删除?能不能让被误判的人申诉?能不能禁止把为一个目的收集的数据转给另一个目的?
AI 让监控变便宜、变快、变自动。正因为如此,限制它也要更早、更具体。等到系统已经铺满公共生活,再谈边界,通常就晚了。
参考来源
- The Guardian:AI surveillance is accelerating and will inhibit social progress:原始评论。
- Bruce Schneier:作者安全与隐私研究背景。
- EFF:Street-level surveillance:公共监控技术背景资料。
评论
围绕这篇文章补充信息、提出问题或分享观察。